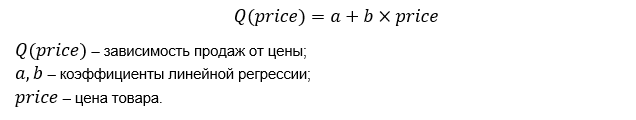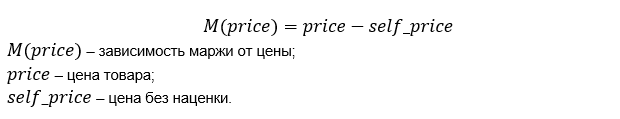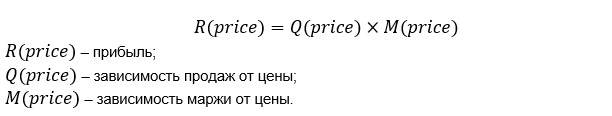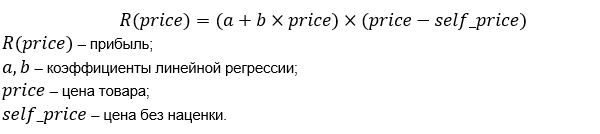11 новых ожидаемых возможностей Tableau 9.3

Мы невероятно взволнованы: версия 9.3 уже доступна! Она имеет множество новых возможностей. Ниже приведены некоторые из важнейших и, по моим оценкам, достойных рассмотрения.

Я разделил их на 3 группы: новые возможности-хедлайнеры, о которых все говорят; простые новые возможности, которые являются функциональным расширением, не обязательно важнейшими, но все же очень занимательными; и новые маленькие возможности – это небольшие малоизвестные улучшения, относящиеся к пользовательскому интерфейсу или функционалу. Существует множество интересных возможностей, которые делают все немного проще и поэтому понравятся пользователям Tableau.

Хедлайнеры

    1. Объединения

Да, наконец мы можем ликвидировать эти ужасные пользовательские sql, так как Tableau предоставил возможность сделать это в окне конфигурации источника данных! Посмотрите ниже, насколько просто объединять данные.
Даже есть возможность принимать подстановочный знак ввода из файлов, так что вам не нужно указывать имя каждого файла, а надо лишь направить Tableau к папке Excel или текстовому файлу, и программа позаботится обо всем остальном сама.

    1. Журнал версий

Долгожданное требование корпораций теперь размещено на сервере Tableau Server: рабочие журналы и источники данных, опубликованные на сервере Tableau, теперь будут иметь историю версий, так что теперь у вас есть возможность обращаться к предыдущим версиям в случае, если вы случайно опубликовали сделанную в пятницу после обеда версию панели управления своего СЕО с изображением кота.

    1. Новая возможность нанесения данных на карту

Всем нравятся хорошие карты, а с Tableau размещение данных на картах стало исключительно простым: часто для этого потребуется просто дважды кликнуть мышкой. Версия 9.3 выпущена с некоторыми обновлениями нанесения данных на карты, которые понравятся британцам, так как сначала отображается почтовый индекс, привычный нам. Другие обновления таковы:

      • Районы Индии;
      • Демографические слои данных США на 2016 год;
      • Обновления почтовых индексов США на 2016 год;
      • Обновления почтовых индексов для Великобритании, Франции и Германии;
      • Добавлены почтовые индексы для 39 стран Европы, включая Бельгию, Италию, Нидерланды, Испанию, Швецию, Швейцарию и другие.

Простые возможности

    1. Предустановленные драйверы

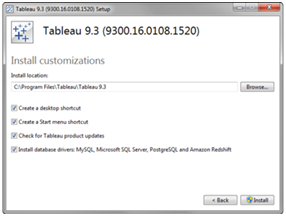
О, сколько раз я пытался установить панель управления Tableau на новое устройство и сколько раз не мог подключиться к моим данным, и я понял, что это было из-за отсутствия драйвера. К счастью, для MS SQL Server, MySQL, Postgres и пользователей Amazon Redshift, те времена уже давно стали историей. Теперь во время установки вы получаете небольшой список задач с полем пометки о выполнении, где вы можете выбрать включение этих драйверов как части установки. Очень здорово: это должно убрать головную боль некоторых ИТ-специалистов и пользователей!
    1. Повышение производительности

Все работает быстрее. Нужны ли вам детали? Конечно, но это довольно утомительно расписывать, поэтому прочтите об этом в свое свободное время. Если обобщить, то управление памятью было усовершенствовано в движке данных так, что запросы извлекаются и загружаются намного быстрее. Также отмечу, что при загрузке рабочего журнала в Tableau Server программа подключается только к источнику, необходимому для отображения ваших данных. Это означает, что при наличии нескольких таблиц в рабочем журнале Tableau подключится только к необходимому источнику, таким образом, у вас будет возможность отображать данные максимально быстро.

И, наконец, в сервере Tableau различные места, где кэшируются ваши данные и визуализации, теперь синхронизируются более эффективно, так что вы получите еще более быструю загрузку и доступ к вашей визуализации при открытии рабочего журнала во второй раз.

    1. Поддержка дисплеев высокого разрешения

Поддержка дисплеев высокого разрешения внесена в продукт, с учетом всего нескольких незначительных упущений выпускаемых версий. Те, кто пользуются дисплеями с высоким разрешением в ноутбуках с ОС Windows, должны знать о некоторых недостатках, но ходят слухи, что версия 9.3 содержит инструменты масштабирования и строки меню, окна данных и макеты, а также другие элементы.

    1. Загрузка прогрессивной панели управления

Итак, это отличная возможность сэкономить время. При загрузке панели управления на сервере Tableau каждый лист на ней будет воспроизводиться индивидуально, по мере его готовности – в отличие от воспроизведения всего и сразу, как это происходит сейчас, что приводит к длительному ожиданию отображения каких-либо данных.

Новые маленькие возможности, которые вы полюбите

    1. Цветное кодирование управления общими и промежуточными данными

Подводим промежуточные итоги выбранных табличных данных? Без проблем! Я предпочитаю воспринимать выбранные табличные данные как первый шаг (после выхода из области перекрёстных таблиц) в перемещении к визуальной аналитике, и это было последним камнем преткновения на этом пути, так что я знаком со многими людьми, которые очень обрадуются таким нововведениям.

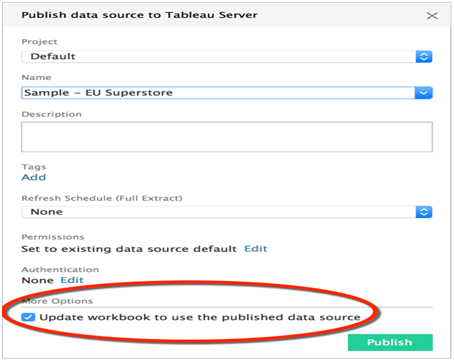
Публикация источника данных автоматически заменяет локальный источник данных на опубликованный

Никакие описания здесь не требуются. Эта возможность позволит Tableau сэкономить миллионы кликов, в результате чего повысится продолжительность жизни мыши и снизятся продажи мышек в сфере аналитики.
Прокрутка для увеличения масштаба карты

Теперь это работает, как и в Google-картах! Теперь, когда ваша мышь перемещается на карту Tableau, вы можете изменить масштаб без необходимости удерживать определенный контроллер или командную кнопку. Другая удачная возможность – при выполнении двойного клика карта будет центрироваться в месте расположения курсора мыши.

Теперь руководители проектов могут менять владельца, ЗАПУСКАТЬ ОБНОВЛЕНИЯ ВЫПИСОК и перемещать контент

Пользователи, выполняющие роль руководителей проекта в Tableau Server, теперь получили больше возможностей контроля над содержимым проекта: они могут обновлять выписки по требованию, перемещать содержимое из одного проекта в другой (при условии, что они являются руководителями обоих проектов) и изменять структуру содержимого в своем проекте.
Это большой шаг на пути к созданию усиленной роли администратора контента, находящегося между издателем и администратором сайта, а также должно оказать помощь в планировании развертывания Tableau Server.


Найти решение у бизнес-партнера Tableau в России.

Форум разработчиков Tableau. Получите ответы на все вопросы по Tableau!

5 вещей, которые я хотел бы знать о Tableau, когда начинал его использовать

С самого первого дня знакомства с Tableau я понял, что эта платформа станет фантастически удобным инструментом для визуализации данных, составления больших отчетов и анализа информации. Три года спустя я пришел к выводу, что должен освоить и более продвинутые функции Tableau, которые действительно помогут повысить эффективность его использования. Однако если бы я мог вернуть время на 3 года назад и уже тогда разобраться с пятью основополагающими принципами работы Tableau, я бы избежал многих проблем.

Зеленый против Голубого

Зеленые поля данных являются непрерывными (могут содержать бесконечное число значений), а синие поля данных – дискретными (содержат конечное число значений). Tableau работает по-разному в зависимости от того, какой тип поля используется для визуализации. Я не буду вдаваться в подробности, но подчеркну еще раз, что голубым будут заданы заголовки, цвета категорий и мультивыборные фильтры, а зеленым цветом задаются оси, градиентные цвета и фильтры диапазона. Это основополагающие вещи для понимания тех принципов, в соответствии с которыми Tableau представляет материал на экране: если вы не понимаете этих различий, я рекомендую вам прочитать статью трижды, прежде чем приступать к работе!

Разбивка и адресация

Табличные расчеты являются одним из самых мощных инструментов в Tableau, но они также и одни из самых сложных. Когда я начал использовать табличные расчеты, в основном я думал над тем, что же предпринять для получения корректных результатов. Изучив основы теории (в частности, разобравшись, что подразумевается под «разбивкой» и «адресацией»), я смог понять, что, где, когда, почему и как производится в табличных расчетах.

Руководство по Tableau гласит:
«Поля адресации определяют, какую часть таблицы вы обрабатываете. Поля разбивки определяют, как сгруппировать расчеты».
Что касается меня, то я не нахожу это пояснение полезным. Давайте попробуем перефразировать и упростить его таким образом, чтобы его можно было применить к расчету таблицы, с которой мы работаем в Tableau. Если поля разбивки «группируют вычисления», мы могли бы начать говорить «на одного клиента», или «на один продукт», или «по способу передачи, комбинации хранилища» и т.д.
Полями адресации являются те, которые используются в производимом расчете. Исходя из этого можно продолжить примеры: «вычислить % от общей суммы для каждого региона» или «вычислить разницу для каждой категории». Составьте эти два утверждения вместе, и мы получим что-то, напоминающее обычное предложение и более понятное.

В приведенном выше примере мы получаем «вычисление процента по каждому региону от общего числа по каждой категории». Мне чтение вслух утверждений такого типа помогает определить, как настроить вычислительную операционную панель.
Примечание: При использовании кнопки быстрого доступа меню «Compute using» («Вычислить, используя»), будет установлено все, выбранное в ячейке адресации («для каждой»), а также для любого другого измерения, используемого в отображении ячейки разбивки.

Tableau прописывает язык запросов с помощью перетаскивания

Tableau – довольно грамотное программное обеспечение, использующее все виды передовых технологий, что позволяет быстро создавать сложные визуализации из огромных массивов данных с помощью простого перетаскивания. Но само ядро Tableau «разговаривает» с вашими данными, используя форму SQL, а затем из источника данных направляет на экран результаты через «переводчик». Понимая то, что происходит внутри приложения, вы сможете управлять им очень эффективно и элегантно. Установите параметр на строку, а меру в ячейку, и вы напишете запрос вдоль строк:

SELECT Region, Sum(Sales) FROM Orders GROUP BY Region

Задайте другие параметры в поле фильтра, и будет добавлено условие «WHERE» («ГДЕ»). Выполните сортировку, и вы получите «ORDER BY» («УПОРЯДОЧИТЬ ПО») и т.д.
Почему это важно? Всякий раз, когда я останавливаюсь и не знаю, какие поля использовать или как их настроить, я спрашиваю себя: «Как бы я сделал это без Tableau?», то есть какие шаги необходимо предпринять, чтобы получить необходимый результат в базе данных или электронной таблице. Использование такого взгляда на настройку часто помогает мне обнаружить недостающее звено, необходимое в Tableau.
Конечно, если вы не знакомы с базами данных и SQL, вы все равно можете стать опытным пользователем Tableau, но, если у вас уже есть хотя бы небольшой опыт работы с фоновым анализом данных, он поможет вам усовершенствовать работу с Tableau. Проверьте файл log.txt в каталоге «My Tableau Repository» («Мой архив Tableau»), чтобы увидеть, что происходит в фоновом режиме.

Порядок операций

При добавлении поля в визуализацию или поле фильтров, а также при выполнении пользовательского вычисления кажется, что все эти элементы вычисляются одновременно. На самом деле в Tableau все делается в определенном порядке, и, зная этот порядок, можно легко построить вашу визуализацию, добившись необходимых результатов.

Порядок обработки процессов:

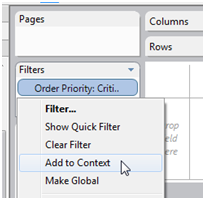
Контекстные фильтры создают временную таблицу в источнике
Верхний N- и/или условные фильтры — часть вашего оператора SELECT (ВЫБОР) в запросе
Стандартные фильтры применяются в качестве условия WHERE (ГДЕ)
Вычисляются массивы
Применяются табличные расчеты
Создается макет таблицы и осей
Учитываются все поля страницы
Рисуется разметка

Знания о том, что стандартный фильтр вводится после активации верхнего N-фильтра, но прежде производится табличный расчет, могут помочь вам выйти из ситуаций, когда, например, не отображается процент от общего количества при фильтрации.

Использование функции INDEX (и ее близких родственников)

Несмотря на то, что я рассмотрел все доступные функции решения еще на раннем этапе своего стремления стать опытным пользователем Tableau и был осведомлен о функциях INDEX, FIRST и LAST, до недавнего времени я использовал их неправильно. Теперь я знаю, что они делают, и использую их все время для достижения необходимого результата.
По сути, INDEX создает ранжированную или упорядоченную визуализацию деталей на экране либо использует другие метрики: это гибкая функция, которая позволяет сортировать, фильтровать и отображать данные такими способами, которые в иных случаях не доступны.


Найти решение у бизнес-партнера Tableau в России.

Форум разработчиков Tableau. Получите ответы на все вопросы по Tableau!
Три примера, как вы можете пересмотреть будущее рабочей атмосферы в своей компании

Рекрутмент: PwC использует геймификацию для моделирования того, что значит работать в фирме

В течение последних двух лет PwC Hungary поставила перед собой цель: более полно задействовать свой пул кандидатов на работу в процессе поиска. Обычно эти кандидаты тратили менее 15 минут на карьерный веб-сайт, и фирма была заинтересована в создании более профессионального кандидата. Результатом этого стала разработка и запуск игры под названием Multipoly, которая позволяет кандидатам на вакансию PwC практически проверить свою готовность работать в фирме, работая в командах для решения реальных бизнес-задач. Multipoly (как монополия на финансовом рынке, если понимаете, о чем я) представляет пользователям задачи, основанные на компетенциях PwC, которые фирма разрабатывает для нынешних сотрудников, таких как создание деловой хватки, повышение цифровых навыков и использование навыков взаимоотношений. Noémi Biró, региональный менеджер по набору персонала PwC в Венгрии, заметила, что кандидаты, которые играли в игру Multipoly, были лучше подготовлены к «живым» очным собеседованиям, так как игра «предварительно ознакамливала [их] о PwC и ее видении, службах и навыках, необходимых для успеха». Biró говорит, что новые работники, которые знакомы с Miltypoly также обозначают работу в среде PwC проще, поскольку они уже прочувствовали культуру компании через игру ».
Теперь сравните процесс игры в Multipoly с посещением страницы карьеры PwC. Кандидат может потратить 5-10 минут на страницу карьеры против полутора часов, играя в Multipoly до собеседования!
Когда PwC запустил Multipoly, фирма сообщила о росте числа кандидатов на работу в 190%, причем 78% пользователей сообщают, что они заинтересованы узнать больше о работе в PwC.

Обучение сотрудников: Walmart использует короткие игры для усиления подготовки по вопросам безопасности

Walmart начал использовать геймификацию два года назад, чтобы обеспечить подготовку по безопасности для 5000 сотрудников в восьми центрах распространения Walmart. Игровой тренинг по безопасности рассматривал значительную деловую проблему: обеспечение того, чтобы широко разбросанная рабочая сила придерживалась процедур безопасности на работе.
Игровая платформа Walmart была предоставлена как всего лишь трехминутные приложения, которые были встроены в рабочий процесс участника. Именно этот «эмоциональный аспект» геймификации имеет самые глубокие преимущества для изменения поведения сотрудников. Результаты на сегодняшний день впечатляют: на 54% снижение числа инцидентов среди восьми распределительных центров Walmart, использующих геймификацию.

Внутреннее сотрудничество: Qualcomm использует гэймификацию для расширения сотрудничества между работниками

Qualcomm моделирует технику геймификацию, основанную на сервисе stackoverflow.com, где сотрудники задают технические вопросы, отвечают на них, голосуют за понравившиеся, а лучшие из ответов попадают в топ. В этой форме геймификации сотрудники Qualcomm получают баллы за уровень своей активности и участия, а затем особые значки за то, что они справляются с непопулярными заданиями, например, отвечая на вопрос, который остается без ответа в течение 30 дней. Сотрудники, которые делают это, получают значок «Археолог» и высокое признание на сайте! Кроме того, значок будет отображаться в профиле сотрудника и будет указывать на их готовность поделиться своими знаниями.

Сладкий путь, на котором геймификация помогает M&M стимулировать вовлеченность клиентов


Это было не так давно, когда выбор методов маркетинга был относительно небольшим, а сообщения были простыми. Компании рекламировали свои продукты через древний способ печатной рекламы. В конечном счете, реклама являлась как верный способ привлечь внимание к широкой аудитории. Но цифровой век затмил такой старый способ вещания, и компаниям нужны новые способы поддержки взаимодействия с потребителями. M&M’s, старый добрый стабильный игрок сладкого рынка, справился с этими сложными цифровыми задачами с помощью геймификации.
В США, M&M’s обратились к стратегии геймификации для продвижения их фирменного сладкого продукта. По данным Digital Training Academy, маркетинговые усилия компани подразумевали шпионскую игру в рекламной кампании. Рекламные изображения, размещенные в Интернете, состояли из изображений M&Ms. Кампания бросила вызов потребителям, чтобы найти единственный крендель, скрытый в изображении.

M&Ms обнаружили, что игра очень хорошо привлекает потребителей. Рекламная кампания принесла также очень сладкие результаты для компании. По данным Digital Training Academy, в результате маркетинговых усилий M&M было собрано более 25 000 лайков на фирменной странице Facebook, плюс 6000 репостов и 10 000 комментариев.
Из-за того, что потребители живут в цифровой жизни, значит, что маркетинговые кампании не должны застревать в прошлом. Более 77 процентов американцев владеют смартфонами, и многие из них связаны с брендами через «микро-моменты», — пишет в AdExchanger Пол Полицзотто, президент и основатель CBSEcoMedia. «Реклама с элементами игры может стать идеальным способом привлечь эту аудиторию и, как было показано, увеличить вовлеченность потребителей», — говорит Полицзотто.
Но есть верный и ошибочный путь цифрового взаимодействия с потребителями. Если игра сложная или громоздкая, пользователи потеряют интерес. По словам Полицзотто, гениальность кампании M&Ms заключается в том, что она основана на относительно простой концепции «спрячь и найди». Если кампания может успешно управлять взаимодействием с потребителями, у нее есть более сильная вероятность распространения интереса одного потребителя через репосты и обсуждения другим.

Разработка своего коннектора 1С для QlikView на C#

На сайте QlikCommunity можно найти материалы по SDK (v.11, v.10) для разработки своего коннектора. Нужные файлы находятся в разделе QVX SDK Libraries and Examples (QvxSDK_2.0.zip). В архиве находятся примеры, необходимые файлы для разработки, и документация. Для разработки нам потребуется Visual Studio. Знание C# необязательно, документации, примеров и умения пользоваться поиском оказалось вполне достаточно для создания примитивного коннектора.
Принцип работы коннектора

Создаем в Visual Studoi новый проект, копируем файлы QvxLibrary.dll и verpatch.exe из архива SDK в каталог проекта.

Добавляем ссылки на необходимые библиотеки в обозревателе решения.

На вкладке COM подключаем коннектор 1С.

На вкладке Обзор подключаем библиотеку QlikView

Выделяем проект C# (пункт connector1c), нажимаем Свойства (Alt+Enter).

Открываем вкладку «События построения», определяем событие после построения, в моем случае это «$(ProjectDir)verpatch.exe» «$(TargetPath)» /s «QlikView Connector» «start1c.blogspot.com»
Это нужно для того, чтобы после компиляции проекта запустился verpatch.exe и пропатчил созданный файл, иначе QlikView его не увидит. Наличие строки «QlikView Connector» обязательно, вторую строку определяете по своему усмотрению.

Создаем первый класс Program.cs

using System;
using System.Collections.Generic;
using System.Linq;
using System.Runtime.InteropServices;
using System.Windows.Forms;

namespace connector1c
{

static class Program
{
///

/// Главная точка входа для приложения.
///

[STAThread]
static void Main(string[] args)
{
if (args != null && args.Length >= 2)
{
new Connector().Run(args[0], args[1]);
}
}
}
}

Класс Connector.cs отвечает за создание строки подключения для скрипта загрузки.

using System;
using System.Collections.Generic;
using System.Linq;
using System.Text;
using QlikView.Qvx.QvxLibrary;
using System.Windows.Interop;
using System.Windows.Forms;
using System.Runtime.InteropServices;

namespace connector1c
{
internal class Connector : QvxServer
{

QvConnector qv_connector;

public override QvxConnection CreateConnection()
{
qv_connector = new QvConnector();
return qv_connector;
}

public override string CreateConnectionString()
{
var base_connector = CreateBaseConnector((qv_connector == null) ? null:qv_connector.MParameters);
base_connector.ShowDialog();
string connectionString = null;
if (base_connector.DialogResult.Equals(true))
{
if (base_connector.GetServerBase())
{
connectionString = String.Format(«Srvr={0};Ref={1};UserId={2};Password={3};Query={4};QV_Table={5}»,
base_connector.GetBaseLocation(),
base_connector.GetBaseName(),
base_connector.GetUser(),
base_connector.GetPassword(),
base_connector.GetQueryText(),
base_connector.getQV_Table());
}
else
{
connectionString = String.Format(«File={0};UserId={1};Password={2};Query={3};QV_Table={4}»,
base_connector.GetBaseLocation(),
base_connector.GetUser(),
base_connector.GetPassword(),
base_connector.GetQueryText(),
base_connector.getQV_Table());
}

}
return connectionString;
}

private BaseConnector CreateBaseConnector(Dictionary mParams = null)
{
var base_connector = new BaseConnector(mParams);
var wih = new WindowInteropHelper(base_connector);
wih.Owner = MParentWindow;
return base_connector;
}

}
}

Класс QvConnector.cs реализует подключение к 1С по COM соединению, передачу текста запроса и считывание результата.

using System;
using System.Collections.Generic;
using System.Diagnostics;
using System.Security.Authentication;
using System.Text.RegularExpressions;
using QlikView.Qvx.QvxLibrary;
using System.Runtime.InteropServices;
using System.Reflection;
using System.IO;

namespace connector1c
{
[ComVisible(true)]
class QvConnector : QvxConnection
{

string connString;
V82.COMConnector v8connector;
string Srvr, File, Ref, Usr, Pwd, Query, QV_TableName;

public override void Init()
{

MParameters.TryGetValue(«File», out File);
MParameters.TryGetValue(«Srvr», out Srvr);
MParameters.TryGetValue(«Ref», out Ref);
MParameters.TryGetValue(«UserId», out Usr);
MParameters.TryGetValue(«Password», out Pwd);
MParameters.TryGetValue(«Query», out Query);
MParameters.TryGetValue(«QV_Table», out QV_TableName);

if (Srvr == null)
{
connString = «File='» + File + «‘;Usr='» + Usr + «‘;Pwd='» + Pwd + «‘;»;
}
else
{
connString = «Srvr='» + Srvr + «‘;Ref='» + Ref + «‘;Usr='» + Usr + «‘;Pwd='» + Pwd + «‘;»;
}

dynamic v8com = GetV8Connect();
if (v8com == null) return;

dynamic v8qBuilder = v8com.NewObject(«QueryBuilder»);
v8qBuilder.Text = Query;
var v8Fileds = new QvxField[v8qBuilder.Result.Columns.Count];
int i = 0;
foreach (var v8Column in v8qBuilder.Result.Columns)
{
v8Fileds.SetValue(new QvxField(v8Column.name, QvxFieldType.QVX_TEXT, QvxNullRepresentation.QVX_NULL_FLAG_SUPPRESS_DATA, FieldAttrType.ASCII), i++);
}

MTables = new List {
new QvxTable {
TableName = QV_TableName,
GetRows = GetData,
Fields = v8Fileds
}
};

Marshal.ReleaseComObject(v8qBuilder);
Marshal.ReleaseComObject(v8com);
Marshal.ReleaseComObject(v8connector);

}

private dynamic GetV8Connect()
{
v8connector = new V82.COMConnector();
return (v8connector == null) ? null : v8connector.Connect(connString);
}

private IEnumerable GetData()
{
QvxTable table = FindTable(QV_TableName, MTables);

if (table == null) yield return null;

dynamic v8com = GetV8Connect();
if (v8com == null)
{
yield return new QvxDataRow();
}

dynamic v8Query = v8com.NewObject(«Query»);
v8Query.Текст = Query;
dynamic result = v8Query.Execute;
dynamic m = result.Choose;
dynamic rezColumns = result.Columns;
var columnIdx = new Dictionary();
foreach (var mx in rezColumns)
{
columnIdx.Add(mx.name, rezColumns.IndexOf(mx));
}

QvxDataRow row;
while (m.Next() == true)
{
row = new QvxDataRow();
foreach(var tField in table.Fields)
{
int idx;
if (columnIdx.TryGetValue(tField.FieldName, out idx))
{
row[tField] = v8com.String(m.Get(idx));
};
}
yield return row;
}

Marshal.ReleaseComObject(v8Query);
Marshal.ReleaseComObject(result);
Marshal.ReleaseComObject(m);
Marshal.ReleaseComObject(v8com);
Marshal.ReleaseComObject(v8connector);

}

public override QvxDataTable ExtractQuery(string query, List qvxTables)
{
return base.ExtractQuery(query, qvxTables);
}

}
}

Для реализации ввода параметров подключения создана форма BaseConnector.xaml.


Логика взаимодействия с формой описана в классе BaseConnector.xaml.cs

using System;
using System.Collections.Generic;
using System.Text;
using System.Windows;
using System.Windows.Forms;
using System.Windows.Controls;
using System.Net.NetworkInformation;
using System.Diagnostics;

namespace connector1c
{
///

/// Логика взаимодействия для BaseConnect.xaml
///

public partial class BaseConnector : Window
{
public BaseConnector(Dictionary mParams = null)
{
InitializeComponent();

if (mParams != null)
{
string Srvr, File, Ref, Usr, Pwd, Query, QV_TableName;
mParams.TryGetValue(«File», out File);
mParams.TryGetValue(«Srvr», out Srvr);
mParams.TryGetValue(«Ref», out Ref);
mParams.TryGetValue(«UserId», out Usr);
mParams.TryGetValue(«Password», out Pwd);
mParams.TryGetValue(«Query», out Query);
mParams.TryGetValue(«QV_Table», out QV_TableName);

if (Srvr == null)
{
ServerBase.IsChecked = false;
base_location.Text = File;
}
else
{
ServerBase.IsChecked = true;
base_location.Text = Srvr;
base_name.Text = Ref;
}
username.Text = Usr;
password.Password = Pwd;
query_text.Text = Query;
qv_table.Text = QV_TableName;
}
setVisibility();

}

private void setVisibility()
{
Visibility elemVisibility = (ServerBase.IsChecked.Value) ? Visibility.Visible : Visibility.Hidden;
label_name.Visibility = elemVisibility;
base_name.Visibility = elemVisibility;
label_location.Content = (ServerBase.IsChecked.Value) ? «Сервер» : «Каталог»;
}

private void btnCancel_Click(object sender, RoutedEventArgs e)
{
DialogResult = false;
Close();
}

private void btnOk_Click(object sender, RoutedEventArgs e)
{
DialogResult = true;
Close();
}

private void ServerBase_Click_1(object sender, RoutedEventArgs e)
{
setVisibility();
}

public bool GetServerBase()
{
return ServerBase.IsChecked.Value;
}

public string GetBaseLocation()
{
return base_location.Text;
}

public string GetBaseName()
{
return base_name.Text;
}

public string getQV_Table()
{
return qv_table.Text;
}

public string GetQueryText()
{
return query_text.Text;
}

public string GetUser()
{
return username.Text;
}

public string GetPassword()
{
return password.Password;
}

private void Hyperlink_Start1c(object sender, System.Windows.Navigation.RequestNavigateEventArgs e)
{
Process.Start(new ProcessStartInfo(e.Uri.AbsoluteUri));
e.Handled = true;
}

}
}

После компиляции проекта полученный файл и библиотеку QvxLibrary.dll необходимо скопировать в %PROGRAMFILES%\Common Files\QlikTech\Custom Data\, в моем случае это C:\Program Files (x86)\Common Files\QlikTech\Custom Data\connector1c. Отсутствующие каталоги необходимо создать вручную. После этого запускаем QlikView, коннектор доступен в списке вариантов подключения.

Исходники проекта C#, connector1c.zip. Успехов в создании своих коннекторов.

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

QlikView + 1С без 1С коннектора

В качестве бесплатной альтернативы предлагаю простой способ получения информации из 1С через COM-соединение.
Для экспериментов я использовал демо-базу 1С:Управление торговлей 11. Сначала реализуем тестовую функцию в 1С, открываем Модуль внешнего соединения, пишем код:

Функция TestQlik() Экспорт

Возврат «QlikView успешно подключилось к 1С»;

КонецФункции

Теперь в QlikView настраиваем COM-соединение. Открываем редактор макросов, пишем следующий скрипт, подставляем свои параметры подключения к базе:

sub v82connect

set conn = CreateObject(«V82.ComConnector»)
set v82 = conn.Connect(«File=»»I:\1c_base\demoTRD»»;usr=»»QlikView»»;»)

MsgBox(v82.TestQlik)

end sub

Обратите внимание на настройки параметров локальной безопасности, установлена в «Разрешить системный доступ». Жмем «Тест», если все сделано правильно, должно появиться сообщение «QlikView успешно подключилось к 1С».

Теперь попробуем подгрузить данные из 1С. Сначала сформируем пустую таблицу в скрипте загрузки:

SET ThousandSep=’ ‘;
SET DecimalSep=’,’;
SET MoneyThousandSep=’ ‘;
SET MoneyDecimalSep=’,’;
SET MoneyFormat=’# ##0,00р.;-# ##0,00р.’;
SET TimeFormat=’h:mm:ss’;
SET DateFormat=’DD.MM.YYYY’;
SET TimestampFormat=’DD.MM.YYYY h:mm:ss[.fff]’;
SET MonthNames=’янв;фев;мар;апр;май;июн;июл;авг;сен;окт;ноя;дек’;
SET DayNames=’Пн;Вт;Ср;Чт;Пт;Сб;Вс’;

LOAD * INLINE [
Data, Firma, Partner, Tovar, Quantity, Summa, Cost
];

Запускаем скрипт, размещаем простую таблицу на листе:

В свойствах документа включаем динамическое обновление данных:


Пишем скрипт загрузки в редакторе макросов:

sub v82query

set conn = CreateObject(«V82.ComConnector»)
set v82 = conn.Connect(«File=»»I:\1c_base\demoTRD»»;usr=»»QlikView»»;»)

query_1c = «ВЫБРАТЬ» &_
» НАЧАЛОПЕРИОДА(ВыручкаИСебестоимостьПродаж.Период, ДЕНЬ) КАК Data,»& vbNewLine & _
» ПРЕДСТАВЛЕНИЕ(РегистрАналитикаУчетаПоПартнерам.Организация) КАК Firma,»& vbNewLine & _
» ПРЕДСТАВЛЕНИЕ(РегистрАналитикаУчетаПоПартнерам.Партнер) КАК Partner,»& vbNewLine & _
» ПРЕДСТАВЛЕНИЕ(РегистрАналитикаУчетаНоменклатуры.Номенклатура) КАК Tovar,»& vbNewLine & _
» СУММА(ВыручкаИСебестоимостьПродаж.Количество) КАК Quantity,»& vbNewLine & _
» СУММА(ВыручкаИСебестоимостьПродаж.СуммаВыручки) КАК Summa,»& vbNewLine & _
» СУММА(ВыручкаИСебестоимостьПродаж.Себестоимость) КАК Cost»& vbNewLine & _
«ИЗ»& vbNewLine & _
» РегистрНакопления.ВыручкаИСебестоимостьПродаж КАК ВыручкаИСебестоимостьПродаж»& vbNewLine & _
» ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.АналитикаУчетаПоПартнерам КАК РегистрАналитикаУчетаПоПартнерам»& vbNewLine & _
» ПО ВыручкаИСебестоимостьПродаж.АналитикаУчетаПоПартнерам = РегистрАналитикаУчетаПоПартнерам.КлючАналитики»& vbNewLine & _
» ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.АналитикаУчетаНоменклатуры КАК РегистрАналитикаУчетаНоменклатуры»& vbNewLine & _
» ПО ВыручкаИСебестоимостьПродаж.АналитикаУчетаНоменклатуры = РегистрАналитикаУчетаНоменклатуры.КлючАналитики»& vbNewLine & _
«СГРУППИРОВАТЬ ПО»& vbNewLine & _
» НАЧАЛОПЕРИОДА(ВыручкаИСебестоимостьПродаж.Период, ДЕНЬ),»& vbNewLine & _
» ПРЕДСТАВЛЕНИЕ(РегистрАналитикаУчетаПоПартнерам.Организация),»& vbNewLine & _
» ПРЕДСТАВЛЕНИЕ(РегистрАналитикаУчетаПоПартнерам.Партнер),»& vbNewLine & _
» ПРЕДСТАВЛЕНИЕ(РегистрАналитикаУчетаНоменклатуры.Номенклатура)»

set v8query = v82.NewObject(«Query»)
v8query.text = query_1c
set result = v8query.Execute

set m = result.Choose

do while m.next
set sql_string = ActiveDocument.DynamicUpdateCommand(«INSERT INTO * «& vbNewLine & _
«(Data, Firma, Partner, Tovar, Quantity, Summa, Cost) » & vbNewLine & _
«VALUES (» & m.Data &», «& m.Firma & «, » & m.Partner & «, » & m.Tovar & «, » & m.Quantity & «, » & m.Summa & «, » & m.Cost & «)»)
loop

ActiveDocument.GetApplication.Refresh

end sub

Обратите внимание на написание текста запроса, это связано с особенностями VBScript. Поэтому лучше описание запроса оставлять на стороне 1С, в QlikView передавать только готовый результат. Так же псевдонимы полей в запросе пришлось писать на латинице, кириллицу не воспринимает. Выделяем нашу процедуру в списке редактора, жмем «Тест». Мы увидим что наша пустая таблица заполнилась данными.


Теперь можно построить пару диаграмм:

При желании можно поставить наш скрипт в выполнение после скрипта загрузки:

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

Ценовая эластичность в ритейле

В экономической теории многие разделы посвящены процессу ценообразования в торговле.

Но при практическом использовании инструментов формирования цены ритейлеры сталкиваются со множеством проблем, это приводит к ошибкам при определении цены и, как следствие, потерям в прибыли.

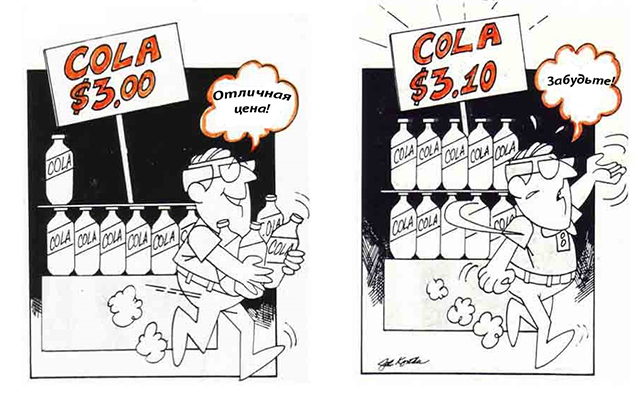
Например, когда ритейлер снижает цену, потребительский спрос растет, но прибыли нет. Увеличивает цену товара — спрос падает.

Как видим, существует сильная зависимость между ценой, спросом и прибылью.

Эластичность же позволяет найти оптимальное соотношение стоимости и количества продаж, позволяющее увеличить прибыль. Иными словами, цена выступает балансирующим фактором между ожидаемыми спросом и доходом.

Многие существующие модели ценовой эластичности претендуют на “мировое господство”, но проблема в том, что учесть при моделировании абсолютно все факторы влияющие на цену и спрос невозможно.

Разработанная нами модель предлагает коррекцию цены на товары по каждому магазину отдельно, используя исторические данные за полгода и учитывая факторы частоты, количества и стабильности продаж, которые повышают точность анализа. Модель не предполагает максимальный охват всех возможных факторов и случаев изменения цены, но срабатывает для корректировки цены отдельных товаров в магазинах наших клиентов.

Наш подход отличается от классического, и ниже мы объясним чем.

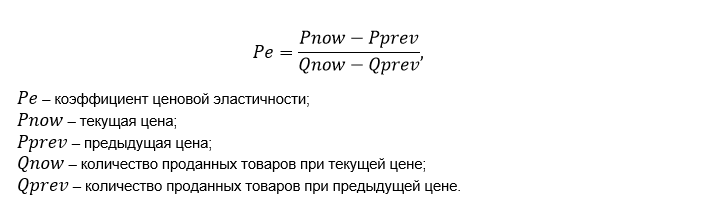
Классическая модель ценовой эластичности — определение коэффициента точечной ценовой эластичности.

Этот подход хорош в теории, но недостаточно достоверный на практике потому что:

  1. На продажи товара влияет множество факторов кроме цены — конкуренция, реклама, лояльность покупателей к бренду, доступность товара и т.п.
  2. Модель не включает фактор времени, а значит исключает важные для ритейла сезонные влияния на покупательский спрос.
  3. Двух показателей цены для точного анализа мало.

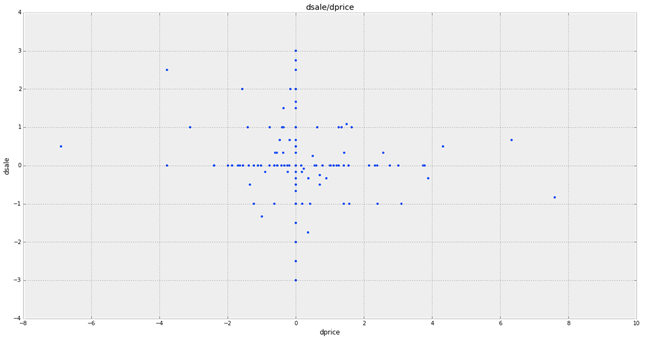
Недостатки модели ценовой эластичности можно увидеть визуализировав соотношение изменений цены и продаж для конкретного товара.

Построим график:
по горизонтали — изменения цены;
по вертикали — изменения продаж товара.

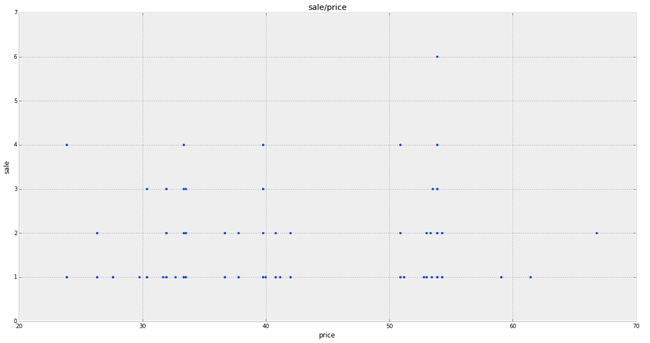
Что мы получили? Большинство точек сосредоточенно около 0, как по у, так и по х. Как видим, изменения цены практически никак не влияют на спрос, да и сам спрос варьируется при стабильной цене. Отследить конкретные зависимости не возможно.

Будем искать другой подход для определения оптимальной цены на товар.

1. Нужно определится с периодом для анализа соотношения цены и спроса.
Выбранный нами период для анализа эластичности цены — полгода. Это позволяет при расчетах минимизировать риски инфляции, других внешних колебаний рынка ритейла.

2. Расчеты проводим для каждого магазина отдельно.
Оптимальная цена для товаров каждого магазина рассчитывается отдельно, так как у каждого магазина свой размер, ассортимент, контингент покупателей, покупательский спрос.

3. Для анализа берем только товары с относительно стабильным спросом, которые продаются не реже чем два раза в неделю.

4. Отслеживаем колебания спроса в зависимости от цены.
Построим график, поместив продажи товара на вертикальную ось, цену товара — на горизонтальную.

Как видим, точки продаж на графике сгруппировались относительно оси Х по изменениям цены.

В продуктовом ритейле, где цены не меняются кардинально, логично будет сгруппировать продажи по изменениям цены с шагом 0,5 грн. Дальше определяем среднее количество продаж в каждой группе и исключаем из анализа все единичные продажи, как недостоверные.

5. Расположим полученные точки средних продаж товара для каждой ценовой группы на графике.

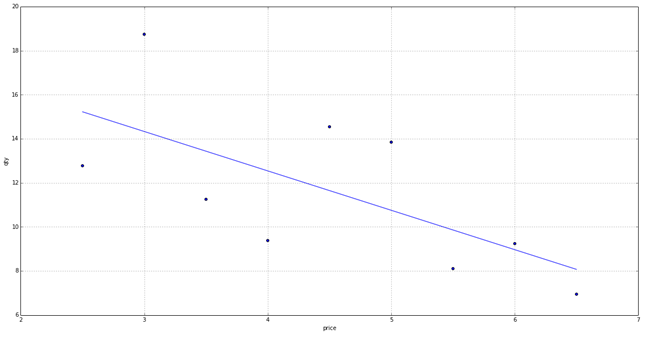
На графике четко видно, что существует зависимость полученных данных и мы можем определить линейную регрессию (тренд).

Экспериментально мы определили что использовать модель можно, если цена на товар менялась хотя бы 4 раза, в противном случае результат будет неточным.

6. Мы получили формулу для определения зависимости количества продаж от цены.

Как недостоверные также будем рассматривать варианты, когда показатель b >= 0. В этом случае по каким-либо причинам, спрос на товар растет, хотя и цена растет. А значит такие показатели необходимо изучать отдельно. Возможен вариант, что спрос для этого товара вообще не эластичен, а значит в нашу модель он не попадает.

Визуально график, когда показатель b >= 0, выглядит так:

7. Построим модель зависимости прибыли от цены товара.
Для этого нам нужно определить зависимость маржи от цены.

Прибыль равна зависимости продаж, умноженной на маржу от цены.

Подставим в формулу зависимость продаж и маржи от цены.

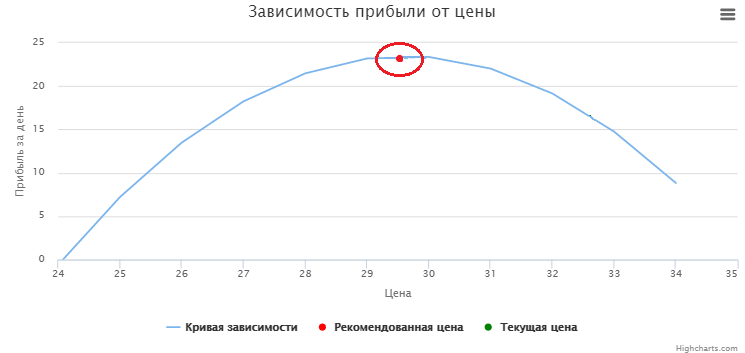
8. Построим график зависимости прибыли от цены товара.
По вертикали — дневная прибыль.
По горизонтали — цена товара.
График начинает строится из точки цены без наценки, в ней полученная прибыль равна 0.


Находим точку на графике, в которой полученная прибыль будет максимальной и определяем значение оптимальной цены.

Модель показывает рекомендации по понижению цены от текущей до оптимальной, что принесет дополнительную прибыль за счет увеличения количества продаж в день.

Рассматривать возможность повышения цены до оптимальной (как на графике ниже) мы не будем. Ведь при формировании цены необходимо учитывать множество внешних факторов: цену конкурентов, ценовую политику сети, государственные рекомендации и ограничения.

Разберем несколько случаев использования функционала BI Datawiz.io для выбора оптимальной цены на товар. Сервис проводит анализ изменения цены и спроса для каждого товара магазина, и на основе описанной модели формирует рекомендации по оптимальному изменению цены на товары, где это повлечет за собой увеличение прибыли.

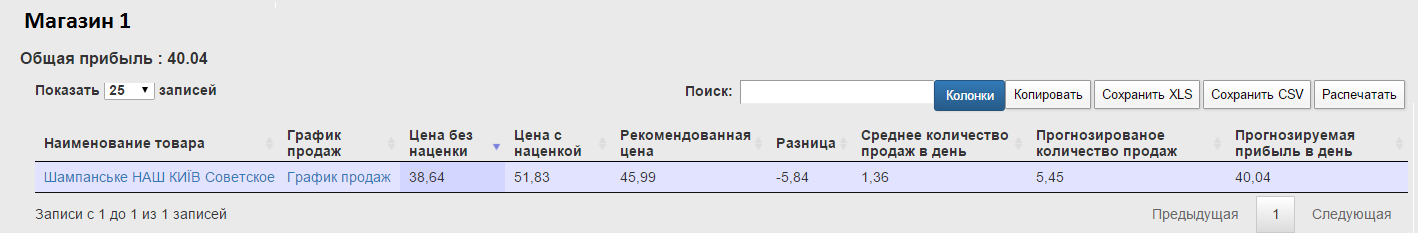
В Магазине 1 сформирована одна рекомендация для товара Шампанское советское от бренда Наш Киев.

В таблице указано:

  • наименование товара;
  • цена без наценки;
  • текущая цена с наценкой;
  • рекомендованная цена;
  • среднее количество продаж в день;
  • прогнозируемое количество продаж при изменении цены;
  • прогнозированное увеличение прибыли по конкретному товару и по магазину в целом.

Т.е. вся необходимая информация для принятия решения.

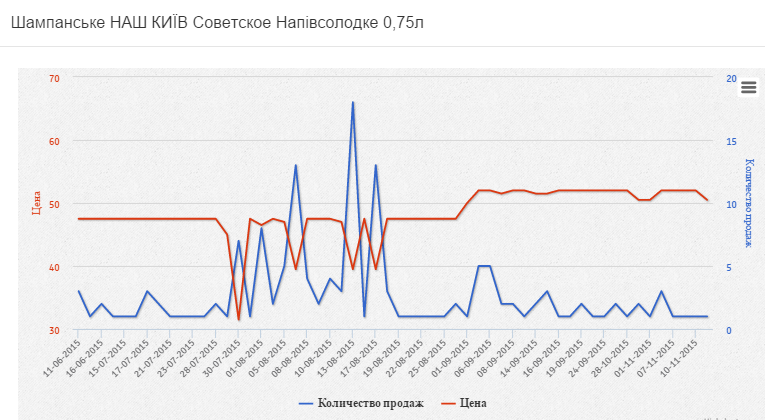
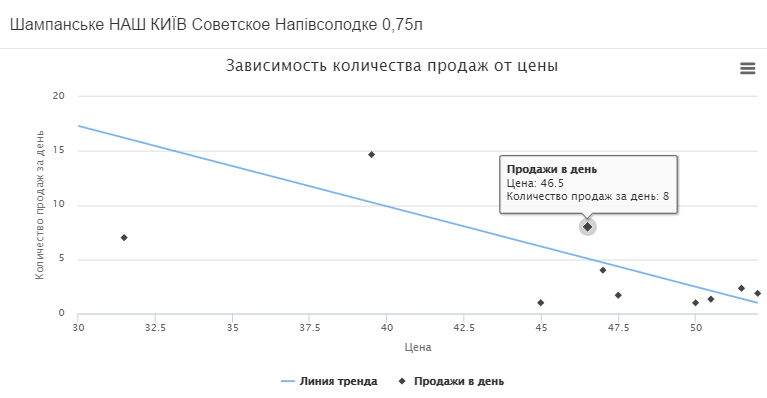
Для более глубокого анализа и обоснованного принятия решений, ритейлер может посмотреть графики зависимости количества продаж от цены и удостоверится в правильности расчетов и рекомендаций.

Как видим, при кратковременном снижении цены (скорее всего в этот период проходили акции на товар), продажи товара значительно увеличивались. Увеличение цены на весь алкоголь, и шампанское в том числе, с 1 сентября повлекло за собой падение продаж.

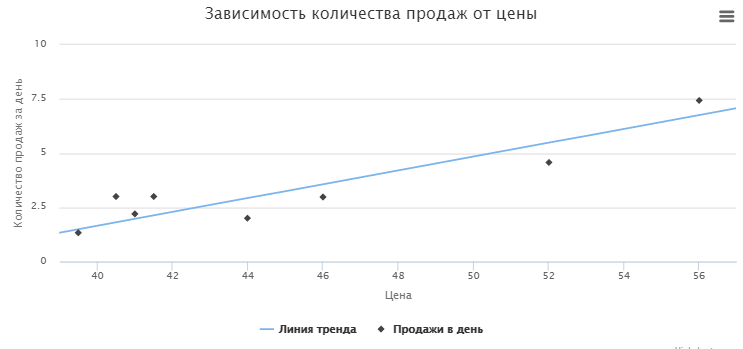
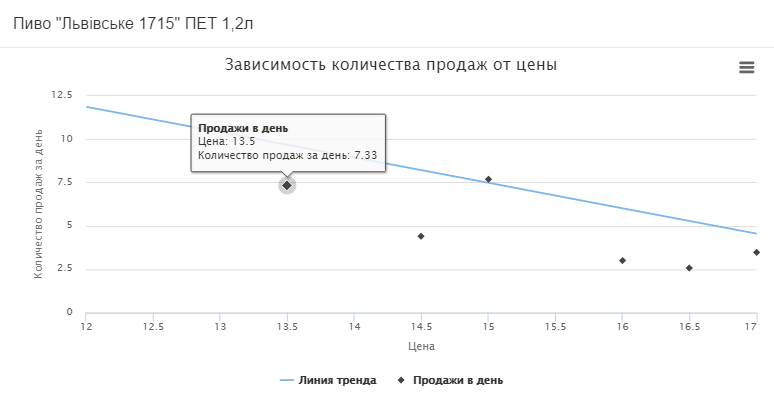
На втором графике мы видим, как менялись средние продажи в день в зависимости от цены и сформированную линию тренда.

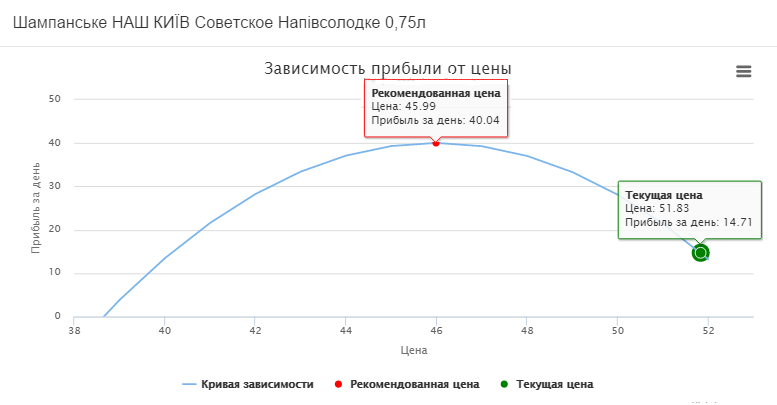
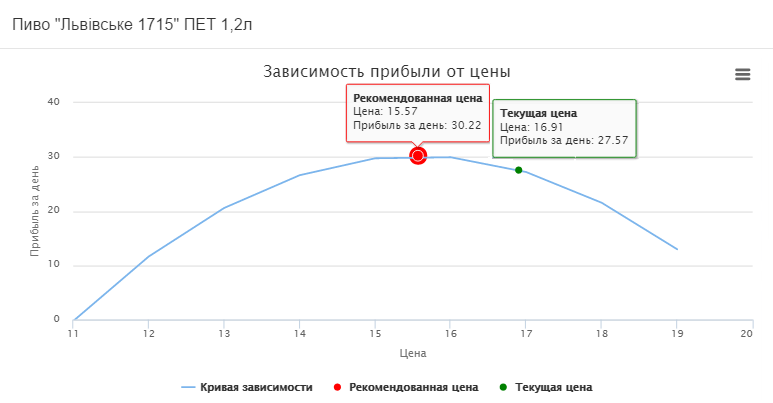
На 3 графике определена текущая и рекомендованная цена для Шампанского наш Киев.

Так, на данный момент шампанское продается по цене 51, 83 грн. за единицу, прибыль в день составляет 14,71 грн. При снижении цены до 45,99 грн. продажи вырастут и полученная дневная прибыль составит 40,04 грн.

Это на 25,33 грн. больше, чем текущая ежедневная прибыль.

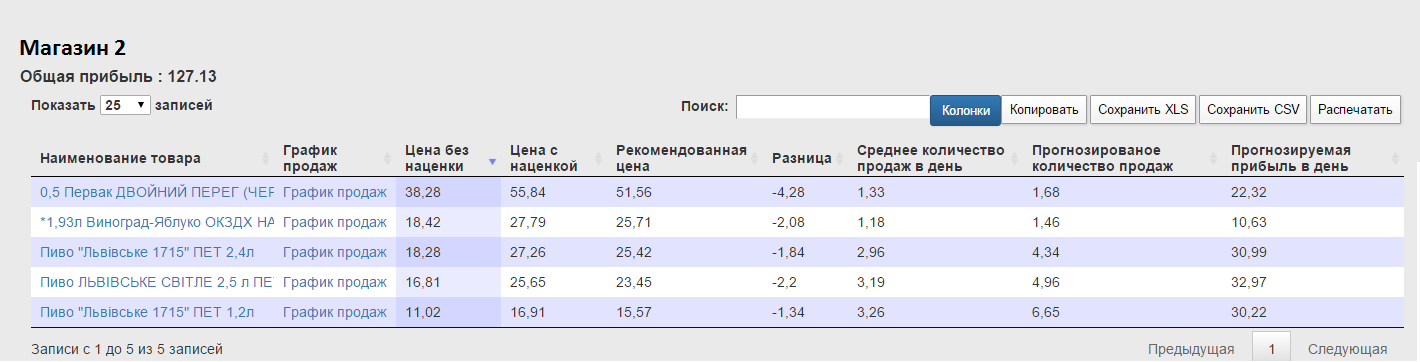
В Магазине 2 мы видим рекомендации по изменению цены для 5 товаров. Общая ежедневная прибыль магазина составит 127,13 грн.

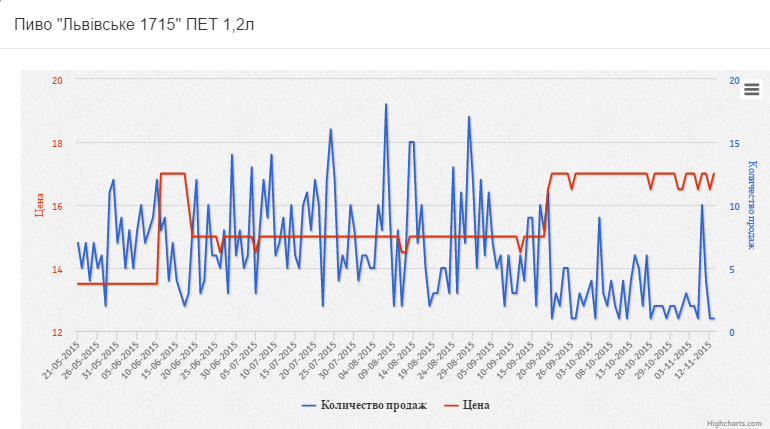
Рассмотрим графики формирования оптимальной цены на примере пива Львовское в ПЕТ бутылках объемом 1,2 л.

Как видим, за текущие полгода, цена на этот товар менялась 6 раз. А покупательский спрос достаточно сильно колебался даже при одинаковой цене.

Тут видна линейная зависимость.

Рекомендуется снизить цену с 16,91 грн. до 15,57 грн. при этом дневная прибыль увеличится на 2,65 грн. и составит 30,22 грн., как видно на кривой ниже.

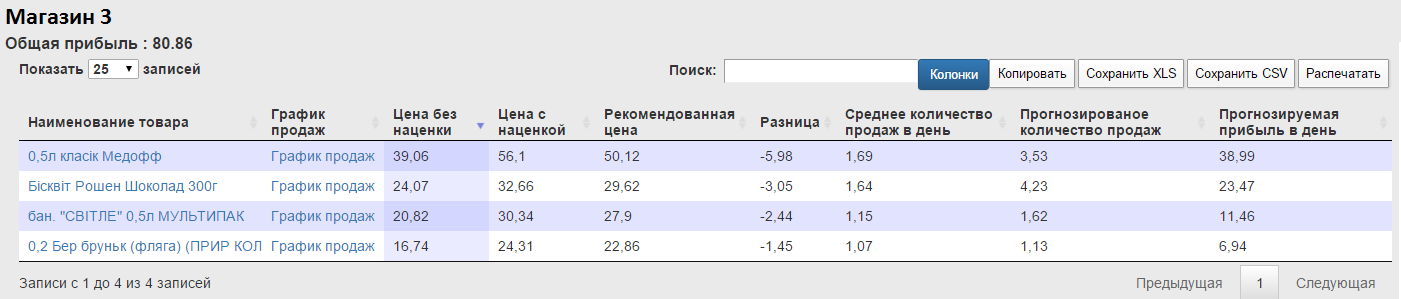
В Магазине 3 сервис построил рекомендации для 4 товаров.

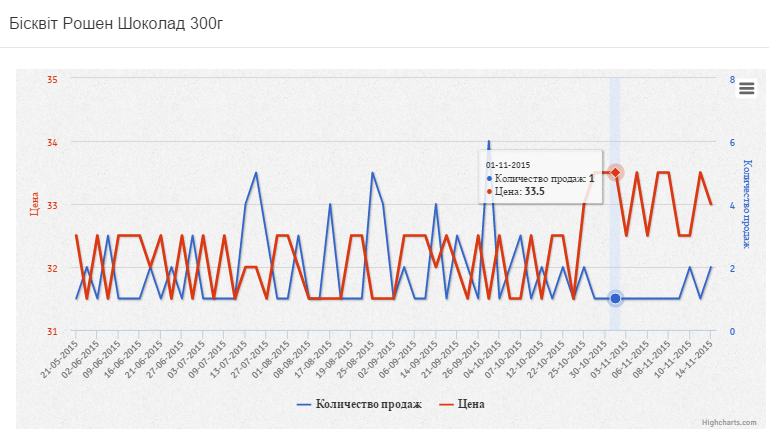
Проанализируем ценовую эластичность товара Шоколадный бисквит от бренда Рошен.

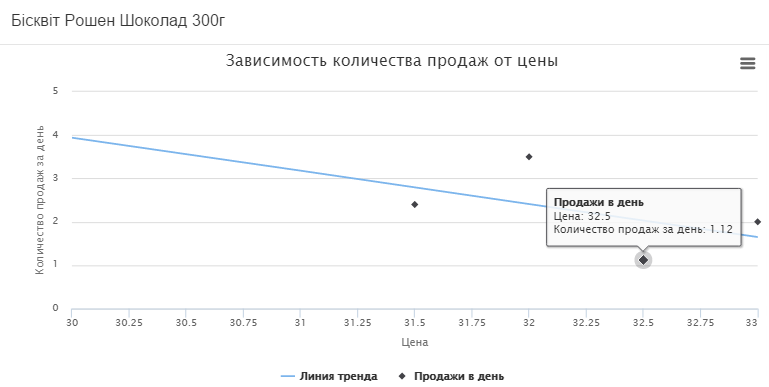
На графике мы видим 5 изменений цены, но при последнем повышении цены до 33,5 грн. каждодневные продажи товара не превышают 1, а значит такие данные мы не используем. Это видно на графике 2, где учитываются 4 показателя продаж.

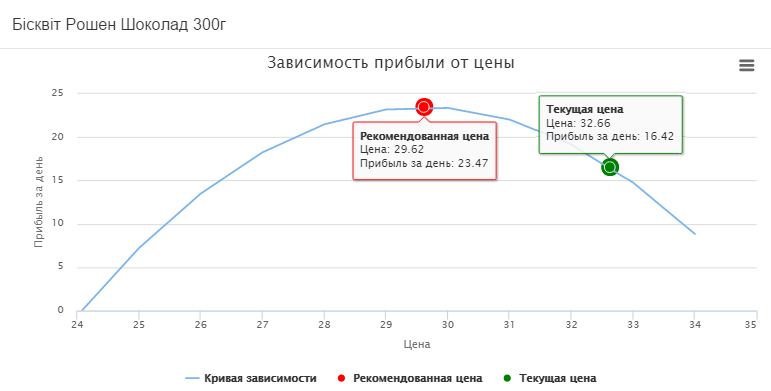
На следующем графике отображается текущая цена бисквита которая составляет 32,66 грн. с каждодневным доходом в 16,42 грн. Рекомендованная цена составляет 29,62 грн., что увеличит прибыль на 7,05 грн.

Заметим, что предложенный нами подход к определению оптимальной цены приближен к практике и реальному состоянию дел в ритейле, исключает риски классического подхода к ценовой эластичности, который использует только два показателя, не учитывает сезонность и другие факторы.

Разработанная нами модель учитывает временной фактор, частоту, количество и стабильность продаж. Дает возможность для самостоятельного анализа с помощью визуализации исторических данных изменения цены и спроса.

Сервис BI Datawiz.io с помощью разработанной модели обрабатывает весь объем данных по продажам и показывает результаты в виде списка товаров, снижение цены на которые принесет прибыль ритейлеру.

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

Практический RFM анализ для увеличения повторных продаж (видео)

В этот раз я поделюсь с вами опытом и наблюдениями как извлекать пользу из RFM даже не имея трёхлетней истории продаж. Мы провели RFM анализ для десятков различных магазинов и столкнулись с рядом преград на пути к получению реальных результатов. До того как описать их все, давайте ещё раз вспомним, что нам даёт RFM. RFM анализ основан на 3 показателях:

  • Recency — давность последней покупки
  • Frequency — суммарная частота покупок
  • Monetary — средний чек

Мне кажется, показатель Monetary не обязательно привязывать к деньгам. Это может быть любой фильтр, наложенный на основные показатели этого метода: Давность и Частота. Например, для информационного портала можно взять время просмотра страницы или глубину просмотра страниц на сайте. RF матрицу можно рассматривать отдельно для разных типов клиентов, фильтруя по источнику клиента, по регионам, по категориям купленых товаров, по возрасту и многое другое.
Если разбить всех ваших клиентов по давности последней покупки на несколько групп и по количеству сделанных покупок, то можно построить матрицу из которой видно как разбить ваших клиентов по группам, на основании их активности:

  • Новички
  • Одноразовые покупатели
  • Растущие
  • Потерянные клиенты
  • VIP

На самом деле групп гораздо больше, но об этом потом. Обычно я строю шкалы по частоте и давности, по принципу: от плохого к хорошему. Получается по давности: слева те, кто покупал очень давно, а справа — кто покупал недавно. По частоте: снизу те, кто сделал одну покупку, а сверху — много. Тогда визуально разделение групп будет выглядеть примерно так:

Об этом мы уже писали и раньше, но давайте посмотрим детальнее как разбить базу на группы и разметить шкалы, сколько групп выделить и что с ними делать дальше.

Самый важный показатель — «Давность». Чем больше времени прошло с момента последней продажи, тем меньше вероятность следующей покупки. И падает эта вероятность очень стремительно. Давайте разберёмся с «Давностью» с самого начала. К примеру, у нас есть 3 клиента (квадрат, круг, треугольник), и на графике мы отметим время когда каждый клиент делал покупку.

Важно, прошу прощения, я почему-то нарисовал график давности в обратном направлении от хорошего к плохому, исправлю, но чуть позже 🙁

Задача — определить сколько клиентов по «Давности» попадёт в каждый из периодов. Важно понимать, что давность — это показатель, который принимает во внимание только последнюю покупку, предыдущие покупки будут отмечены в частоте. Таким образом правильным ответом на задачку будет:

  • Период 1: 1 (только круг)
  • Период 2: 1 (только треугольник)
  • Период 3: 1 (только квадрат, потому что круг и треугольник покупали и после того)
  • Период 4: 0 (все делали покупку после этого)

Если взять и посчитать сколько клиентов попадают в каждый сегмент, то можно построить графики, которые могут выглядеть приблизительно так:

И снова вопрос: какой из трёх вариантов лучше?

Часто я слышу что «красный (3)» — потому что он стабильный. На самом деле, он показывает что мы постоянно привлекаем клиентов, которые делают покупку и не возвращаются снова. Хорошо что показатель немного нарастает, но всё же «сиреневый (1)» — лучше. По нему видно, что большинство нашей аудитории недавно покупали и сильно вовлечены в процесс покупки. Конечно, самый плохой — «зеленый (2)» график. В этом случае у нас был всплеск активности (может быть Новый год или сильные инвестиции в контекст), а потом всё растеряли.

В большинстве книг по анализу, в том числе в популярном издании «Маркетинг на основе баз данных» Артура М. Хьюза, предлагается очень простой механизм разделения «Давности» по сегментам: отсортировать все контакты по давности и разбить на 5 равных групп. То же самое рекомендуется сделать и с Частотой и с Деньгами:

Этот способ работает и помогает разбить всех клиентов на: покупали только что, недавно, так себе, давно, очень давно относительно друг друга. Но что значит «когда»? Если мы не можем сказать точно «когда», то и оценивать эту группу тоже тяжело. Например, в соседние группы могут попасть контакты покупавшие в один и тот же день. Это лишь значит, что для одинаковых клиентов мы будем по разному себя вести… Зачем тогда вообще такой анализ? Всю глубину проблемы я постараюсь показать на двух примерах:

Пример 1: В вашем магазине всё было хорошо, и вдруг в течение месяца ни одной покупки. Всё плохо, но если разбивать на равные части — ничего не изменится и всё те же последние покупатели попадут в сегмент «только что покупали».
Пример 2: Если у вас ещё нет данных о продажах за несколько лет, а Вы только начали свой бизнес, то границы с каждым днём будут очень сильно отличаться и пользоваться результатом такого анализа вообще нет смысла.

Сезонности, акции и праздники тоже сильно влияют на общую картину.

Любой сегмент контактов, о которых вы не можете сказать что-то определённое — плохой сегмент

Мне кажется логичнее фиксировать не количество, а время. Тогда оптимизация количества в группах и будет нашей задачей. Надо как можно больше получить контактов в группе «только что» и как можно меньше «давно».

Осталось только определить какие временные пределы лучше выставить. Для этого надо ответить для себя на несколько вопросов:

  • Какой естественный период покупки?
  • Какая сезонность?
  • За какое время большинство клиентов успевает совершить повторную покупку?
  • Какой период неактивности клиента можно считать, что мы потеряли клиента (длина жизненного цикла клиента)

Для компаний, у которых нет данных, можно предположить эти периоды. Для компаний «с историей» очень помогут несколько графиков (о которых я расскажу дальше) с разницей между покупками.

Я привёл пример графика с разницей в месяцах между первой и второй покупками. У большинства магазинов он выглядит примерно также, как на рисунке. Тут видно, что 50% всех повторных покупок делаются в течение 2 первых месяцев. За полгода 75% процентов делают свой второй заказ и 90% из тех кто покупают снова — покупают в течение 13 месяцев. Какой из этого можно сделать практический вывод? Мне кажется, ненадо спешить давать скидку тем, кто купит и так, без нашей помощи. Предлагать скидку надо через 2 месяца после первой покупки. До этого надо показывать релевантные предложения, быть на слуху и главное — быть полезным клиенту.

Если построить матрицу разности между любыми соседними покупками, то получится примерно следующая картина:


Интересно, что разница между первой и второй покупкой всегда больше, чем между второй и третьей. А между второй и третьей больше, чем между третьей и четвёртой, но чем дальше, тем меньше влияет количество покупок на разницу между ними. Выходит, что вначале человеку надо время, чтобы поверить. Возможно, в следующий раз он попробует купить в другом месте или просто подождёт. Но чем чаще он покупает, тем время между покупками становится меньше. Джим Ново в своей книге Drilling Down говорит, что этот график сначала падает, потом стабилизируется, потом начинает расти. Это очень похоже на жизненный цикл клиента, когда он понемногу перестаёт быть клиентом, все реже покупая. Но я ни разу не видел этой картины на практике.

Важно: для получения этих цифр лучше использовать не среднее, а медиану. Сейчас быстро попытаюсь объяснить разницу. Среднее — это сумма всех значений делённая на их количество, а медиана — это значение элемента, который находится посередине в отсортированной последовательности. То есть гарантировано 50% всех значений меньше или равны медиане, и 50% больше или равны медиане. Медиана лучше среднего, потому что в средних значениях сильное влияние имеют «аномальные значения». Те значения, которые очень редкие, но сильно выходящие за пределы большинства. Обычно медианы значительно меньше средних.

Ещё хорошо бы посмотреть на сезонность — часто это 12 месяцев. Посмотрев на все цифры можно сделать вывод, какой период поставить для групп, например:

  • до 1 месяца
  • до полугода
  • до года
  • до двух лет
  • более двух лет

Но даже с таким подходом есть вопросы. А что если у одних клиентов естественный период покупки маленький, а у других большой? В таком случае я создаю каждому из клиентов профиль и для каждого профиля создаю свою градацию, которую нормализую по оси Давности в относительные категории:

  • ожидаемого времени покупки
  • если не купил — что-то странное
  • мы его теряем
  • мы его потеряли, но есть последний шанс
  • наверняка мы его потеряли

Точно такая же история и для «Частоты», только почти всегда у меня получается приблизительно одна и та же шкала. Те, кто сделали:

  • 1 покупку (этих большинство)
  • 2 покупки (преодолели психологический барьер и пришли снова, уже зная о том, как работает магазин)
  • 3-4 покупки (несмотря ни на что, продолжают покупать. Надо удержать любой ценой)
  • 5-15 покупок (поверили, на них вся надежда. Тут верхняя граница бывает очень разная)
  • больше 15 покупок (маньяки, часто это перекупщики, партнёры, т.п. К ним надо присмотреться отдельно)

Ну вот и весь RF анализ. Если посмотреть на матрицу RF, зная как разбиты сегменты, то сразу понятно кто такие новички: совершили одну покупку совсем недавно. Одноразовые — совершили покупку давно, и уже наверняка забыли об этом. Вряд ли они придут к нам снова. Джим Ново говорит, что таких клиентов всегда 50-60% от всей базы клиентов и с этим надо смириться. Я обычно вижу 70% от всей базе в этом грустном сегменте. Для того, чтобы убедиться, что сегмент грустный можно попробовать вернуть кого-то и для этого Джим Ново предлагает стратегию — «смириться», но если не верите, то начните с:

  1. Тех у кого несколько товаров в чеке
  2. Тех у кого чек больше
  3. Одноразовые покупатели, которые вернули товар — вероятнее придут к вам за второй покупкой, чем те, кто «всем доволен».

Если не удается их вернуть — вам никого не получится вернуть.

Единственная возможность вернуть покупателей за второй покупкой — обратиться к ним как можно быстрее. Но не слишком рано

Обратитесь слишком рано и будете навязчивым и будете предлагать лишние убийственные для бизнеса скидки.

Давайте посмотрим на RF в динамике. Интересно, что по шкале давности мы всегда начинаем с хорошего (только что купили) и скатываемся к плохому (давно не покупал). И как только сделана покупка, мы всегда возвращаемся снова в самый оптимистичный сегмент:

С частотой все наоборот. Начинаем всегда с самого плохого сегмента (1 покупка) и с каждой покупкой становимся лучше. Шансов вернуться обратно практически нет (если считать частоту за какое-то окно (например, 2 года), то частота может уменьшаться)

А теперь посмотрим на всю картину целиком в матрице RF:

Мы всегда начинаем в сегменте «Только что» и с «1 покупки». А мечтаем, чтобы все клиенты попали в сегмент VIP. И самый короткий путь для этого — постоянные покупки. Если со старта клиент ничего не делает, он «сползает» по Давности в «редко», в сегмент «Одноразовых клиентов». Наша цель — не дать ему уйти. Для этого и созданы автоматические реанимационные письма 😉

Есть ещё один тонкий момент: что делать если пауза «затянулась» и клиент не покупал очень давно (значительно превышая жизненный цикл клиента). Мне кажется, в таком случае если он и придет к нам снова, то только если мы снова его «купим» контекстом, сео или разонравится тот магазин, где он все это время покупал. В любом случае к нам придёт совсем другой человек с другими интересами и возможностями. Поэтому мы предлагаем как в детской игре сделать «сброс».

Особенности такого подхода к RFM в том, что его можно применять в первый же день использования магазина. Сразу настроить триггера основанные на неактивности клиента. Следить за динамикой активности ваших клиентов. Кого вы теряете? Что надо сделать, чтобы вернуть клиентов тогда, когда это ещё возможно?
На этом я обзорную статью заканчиваю, и обещаю написать следующую, в которой постараюсь дать ответы на такие вопросы:

  • Как каждый из сегментов читает почту? Сегмент «потерянные» вообще реагируют на почту?
  • Какая доля в продажах каждого сегмента?
  • Какое типичное соотношение клиентов по сегментам?
  • Как изменяется стратегия работы с каждым сегментом?
  • Кому продавать, а кому не мешать покупать?

Хороших клиентов вам, пусть они все идут по самому короткому пути от Новичков в VIP 🙂

RFM анализ в email маркетинге

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

Как использовать ABC-анализ в электронной торговле

Чаще всего ABC-анализ используется в маркетинге для анализа ассортимента товаров. Суть такого анализа заключается в определении значимости каждого товара для компании в целях оптимизации ассортимента. Всем товарам присваивается свой вес в зависимости от выбранного критерия. В рамках электронной торговли таким критерием, например, может быть выручка от товара или количество проданных единиц. Затем товары делятся на три группы: А, В и С. В группу А попадают наиболее важные и ценные товары, в группу С — наименее важные.

Как правило, товары разбиваются на группы неравномерно. Их распределение подчиняется закону Парето, который заключается в том, что 20% товаров приносят компании 80% дохода. В реальности соотношение может меняться, например, 30% на 70%, 40% на 60% и т.д., но суть остается та же — некоторые товары действительно более важны для компании, чем другие. Если взять классический закон Парето, то в группу А помещаются товары, которые все вместе формируют 80% выручки/продаж. В группу B входят товары, обеспечивающие 15% выручки/продаж и в группу С все остальные.

Таким образом, в группе А оказываются товары, от которых зависит успех всей компании. Эти товары жизненно необходимо всегда иметь на складе и на витрине. За этими товарами должен быть строгий контроль, ведь исчезновение этих товаров из ассортимента может грозить компании серьезными убытками.
В группе B находятся товары средней важности. Да, они играют роль в формировании прибыли компании, но не такую критическую, как товары из группы А.
В группе С остаются наименее значимые товары. При сокращении товарного ассортимента эти товары могут быть первыми претендентами на исключение.
Процесс проведения анализа достаточно прост и по его результатам вы сможете ответить на ряд важных вопросов.

  • Какие товары приносят самую большую прибыль?
  • Какие товары являются самыми популярными?
  • Какие товары лучше всего продвигать?
  • Какие товары можно исключить из ассортимента?
  • Как оптимизировать ассортимент?
  • Получение данных для анализа в электронной торговле

    Для проведения простого ABC-анализа необходимо иметь данные по продажам товаров: наименование товара и выручку. Этого будет достаточно, чтобы провести анализ и понять, какие товары наиболее важны для компании c точки зрения приносимой выручки. Поскольку мы говорим об электронной торговле, все эти данные есть в вашей CMS или CRM, в которую поступают заказы с сайта. Кроме того, эти же данные можно взять из Google Analytics, если у вас установлен счетчик и настроена электронная торговля. Для нашего дальнейшего анализа мы будем использовать именно данные Google Analytics.
    Теперь разберемся, какие данные находятся в нем и как мы их можем получить. При настроенной электронной торговле вам будут доступны следующие данные:

    Дата заказа.
    При выгрузке данных вы указываете период, за который хотите получить данные, поэтому если вы хотите провести АВС-анализ сразу за весь период, то это поле вам не нужно выгружать. Оно может пригодиться если вы хотите скачать данные за большой период и отслеживать изменения уже внутри этого периода.

    Название товара и/или идентификатор товара.
    Выберите то поле, которое вам будет удобнее использовать. В идеале и название и идентификатор товара должны быть уникальными, но если у вас названия могут повторяться, то будет лучше проводить анализ на основе идентификаторов товаров.

    Категория товара.
    Если у вас много категорий, то выгрузив это поле, вы сможете провести АВС-анализ не только по товарам, но и по категориям. Это актуально для больших интернет-магазинов, имеющих в ассортименте множество разных категорий товаров. В этом случае целесообразно сначала проводить анализ самих этих категорий и выделять наиболее интересные из них, а затем проводить анализ товаров уже внутри категории.
    Количество товара.
    Количество проданных единиц товара покажет вам, насколько популярны ваши товары. Также вы сможете оценить динамику и стабильность спроса.

    Доход от продукта.
    Позволит оценить выручку каждого товара.
    Выгрузить данные можно двумя способами:

    1. построить пользовательский отчет в интерфейсе Google Analytics и выгрузить его в формате Excel
    2. выгрузить данные через API.

    Мы рассмотрим первый вариант т.к. он прост и доступен всем. Но стоит помнить про ограничение Google Analytics: за раз можно выгрузить не более 5000 строк данных. Поэтому, если данных много, их придется выгружать кусками по 5000 записей из-за ограничения в интерфейсе. Для создания отчета с необходимыми данными перейдите в меню «Мои отчеты» и нажмите на кнопку «Добавить отчет», затем заполните поля как на скриншоте ниже и нажмите сохранить.

    Открыв отчет сохраните данные в нужном вам формате, мы сохраним в Excel:

    Для проведения АВС-анализа придется провести несложную манипуляцию с данными. Это можно сделать, например, в Excel, Google Sheets или Tableau. Мы сделаем это в Tableau и результатом поделимся с вами.

    Применение ABC-анализа для исследования товарного ассортимента

    В результате нашего анализа мы бы хотели определить товары, которые являются наиболее важными для компании, и товары, которые мы могли бы убрать из ассортимента, чтобы перераспределить ресурсы более эффективно.
    Необходимо отметить, что если у вас более-менее крупный магазин, то товары разделены на категории. Как правило, категории очень сильно отличаются друг от друга как по цене, так и по назначению товаров, поэтому сравнивать товары из разных категорий в большинстве случаев бессмысленно и некорректно. Например, если вы продаете смартфоны и аксессуары к ним, то понятно, что все аксессуары попадут в группу С и их надо бы убрать из ассортимента т.к. они генерируют гораздо меньше выручки, однако это было бы ошибочное решение. Поскольку мы выгрузили все товары вместе с их категориями, то будет целесообразно анализировать товары внутри этих категорий.

    Анализ товаров по выручке

    Сначала проведем анализ по выручке. Для этого отсортируем по убыванию все товары по суммарной выручке за весь рассматриваемый период. Затем посчитаем долю каждого товара в общей выручке. Последний шаг — просуммировать эту долю по нарастающей. Теперь мы можем разделить товары на группы по нарастающей доле в выручке.

    В нашем примере будет наиболее оптимально выделить в группу А 30% товаров, которые генерируют почти 70% выручки. Хотя это соотношение отличается от классического правила 20/80, тем не менее видно, что небольшая группа товаров приносит компании 2/3 выручки.
    Также мы представим результаты анализа графически для большей наглядности. На графике отображаются те же данные, что и в таблице: выручка по товарам на левой оси (оранжевые столбцы) и нарастающая доля в выручке на правой оси (синие столбцы). Выглядит это следующим образом:

    На графике наглядно видно, какие товары приносят самую большую выручку – все они попали в группу А. Это самые важные для компании товары, от которых полностью зависит успех бизнеса. Благодаря удобной визуализации вы можете легко понять, какие товары лучше всего собрать в группу А. Прежде всего, это те товары, выручка от которых в несколько раз выше, чем от других товаров. В группу B попали менее важные товары, а в группу С самые незначительные.

    Анализ товаров по популярности

    Пока мы рассмотрели лишь один показатель продаж — генерируемую выручку. Безусловно, это важный критерий оценки товаров, но не единственный. Второй критерий, по которому мы можем провести анализ – это количество проданного товара. Для этого у нас уже есть все необходимые данные и это позволит нам взглянуть на товары с точки зрения популярности: какие товары чаще всего покупают. Разделив товары на АВС-группы по проданному количеству, мы можем столкнуться с тем, что теперь некоторые товары окажутся в другой группе. Например, товар может перейти из группы B в группу А, или наоборот. Бывает, что товары перескакивают сразу из группы С в группу А. Это значит, что хотя они приносят небольшую часть выручки компании, тем не менее их часто покупают. Возможно это аксессуары или сопутствующие товары к каким-то более дорогим товарам. Поэтому отказываться от них будет ошибочно.
    При объединении товаров в группы по количеству продаж мы получили такие данные:

    Например, товар XY0863464-JV, который был в группе В по выручке, теперь перешел в группу А и занял четвертое место. Можно сказать, что этот товар укрепил свою позицию в группе важных товаров.

    Анализ товаров по двум критериям

    Если вы анализируете товары по двум критериям, то можно построить график распределения этих товаров сразу по этим двум критериям. На одной оси поставить выручку, на второй — количество проданных товаров. Этот способ визуализации позволит нам легко понять где товары находятся относительно друг друга.

    Товары, которые находятся справа наверху являются нашими «звездами» — они отлично продаются и приносят нам больше всего денег. Товары в правом нижнем углу также очень популярны, но приносят меньше выручки. Обычно это аксессуары или более дешевые аналоги дорогих моделей. В левом верхнем углу, как правило, находятся дорогие, люксовые товары, которые генерируют большую долю выручки, но продаются редко. Для компании было бы выгоднее всего приложить усилия, для того, чтобы сдвинуть эти товары как можно правее, то есть стараться продавать их в больших количествах. В левом нижнем углу находятся товары, которые и продаются не часто, и выручки приносят немного. Имеет смысл пытаться сдвинуть их правее и выше, а если это невозможно, то подумать о том, чтобы перенести свое внимание и сконцентрироваться на более интересных для компании товарах.

    АВС-матрица

    Вернемся к АВС-анализу по двум критериям. Теперь каждому товару соответствуют две группы: одна – по выручке, вторая — по количеству продаж. Можно построить матрицу товаров, разбив их на 9 групп: AA, AB, AC, BA и т.д. Если использовать больше, чем 2 критерия, то получится многомерная матрица. Это допустимо, но проводить анализ такой матрицы будет в разы сложнее. В нашем примере получается следующая картина (где точка — это один товар, а цветом отображается выручка от товара, чем темнее, тем выручка больше):

    Рассмотрим основные выводы, которые мы можем сделать на основе этой матрицы.

  • В группе АА находятся самые важные товары — они отлично продаются и приносят больше всего выручки.
  • Товары в АВ и АС продаются не очень хорошо, но генерируют большую часть в выручке. Необходимо стремиться повышать продажи таких товаров.
  • Товары из ВА и СА хорошо продаются, но не дотягивают по выручке до лучших товаров. В группе ВА часто располагаются более простые и дешевые модели товаров-звезд. В группе СА как правило находятся аксессуары, дополнительное оборудование, сопутствующие товары, то есть не основные товары. Поскольку эта группа очень популярна и в то же время самая дорогая, то товарами из нее можно привлекать пользователей на сайт. Также эти товары можно предлагать в рекомендательных блоках в качестве дополнения к основному товару в целях повышения среднего чека.
  • В группах ВВ, ВС и СВ находятся средние товары, они не обладают какими-либо отличительными чертами.
  • В группе СС остались аутсайдеры — они и продаются плохо и выручки мало приносят. От таких товаров можно избавляться. При этом следует учесть несколько моментов.
  • В эту группу также попадают все новые товары, которые нельзя исключать из продажи, пока они себя не покажут на более долгом периоде. В принципе, новые товары лучше сразу исключать из АВС-анализа еще во время сбора данных.
  • Дальше необходимо учесть стабильность спроса на товар. Если продажи идут постоянно, пусть и небольшие, то товар можно оставить, а если продажи случаются редко и непредсказуемо, то такой товар можно убрать из ассортимента без вреда для выручки. Например, на графике ниже показана динамика продаж трех товаров. Если какой-то из этих товаров требуется исключить, то это должен быть второй товар т.к. продажи на него самые нестабильные. Избавившись от этого товара, мы сократим складские расходы и сможем отдать место на складе под более перспективные товары.

    Итак, собрав все данные о ваших товарах вместе и разделив на такие группы, вы можете принимать эффективные решения, касающиеся ассортимента товаров вашего магазина. Ниже мы представляем вам отчет в Tableau, который использовали для проведения данного анализа.

    Варианты использования ABC-анализа

    Мы рассмотрели основные моменты АВС-анализа: показали, как проводить анализ, как получать информацию для анализа и на чем основывать ваши решения в оптимизации ассортимента товаров. Сам по себе АВС-анализ является очень простым, но в тоже время очень гибким инструментом. Дополнив информацию о товарах и продажах данными из других источников вам откроются новые возможности АВС-анализа. С его помощью вы можете исследовать ассортимент в разрезе товаров, категорий или брендов товаров, городов и регионов. В качестве критерия для анализа вы можете использовать выручку, количество продаж, маржинальность, стоимость производства или хранения и т.д.
    Разбив товары на АВС-группы, вы можете принимать решения, основываясь на группе в целом, или рассмотреть каждый товар индивидуально. Это потребует больше времени, но результат изменений окажется точнее и эффективнее. Вы сможете понять почему товар находится в той или иной группе и что нужно предпринять для улучшения его позиции. Пристальное внимание должны получить товары из группы С – почему они плохо продаются, нужны ли они компании и вашим клиентам.
    Кроме анализа товаров, вы можете провести аналогичный анализ в разрезе ваших клиентов — кто из них покупает чаще и тратит больше. Это позволит лучше понять ваших клиентов, и, разбив их на группы, сформировать для каждой группы индивидуальное предложение.

    Найти решение у бизнес-партнера QlikTech (QlikView) в России.

    Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

    Как вносить изменения в столбиковую диаграмму цели

    Есть ряд способов показать отклонение от целевого показателя на панели управления. Здесь я приведу пример того, как создать гистограмму, которая легко читается и дает полнозначные сравнения измерений с целями.

    Данный способ может использоваться как в QlikView, так и в Qlik Sense.

    Загрузка некоторых данных

    Этот пример может основываться на любых данных, которые у вас фактически имеются, и загруженных значениях цели. Я создал несколько фиктивных данных с использованием загрузки INLINE. Это хороший способ получения быстрых тестовых данных:

    ActualVsTarget:
    LOAD
    1 asRegionCount,
    Region,
    Target,
    Floor(Target * Factor) asActual
    INLINE[
    Region,Target,Factor
    Northern,200,0.88
    Southern,250,1.67
    Eastern,150,1.33
    Western,200,0.67
    Midlands,225,1.14
    ];

    Очевидно, что в реальном мире было бы намного больше строк и параметров, но и этого достаточно для примера.

    Создайте диаграмму и добавьте измерения

    В Sense, достаточно всего лишь перетащить линейчатую диаграмму на рабочее пространство, в QlikView – можно выбрать Диаграмму из основного меню и сделать её гистограммой на вкладке Общие. Добавление измерения Регион – аналогично, перетаскивание в Sense, или выбор из списка в QlikView.

    Если вы новичок в использовании обоих инструментов, есть множество пособий для начала работы, которые стоит перед этим посмотреть.

    Выражения

    Диаграмма нацелена на отображение фактических и целевых значений в одном графике. Когда фактическое значение меньше целевого – это столбик, находящийся слева, с остатком целевого значения вверху, а когда фактическое значение превышает целевое – общее целевое значение отображается как столбик с остатком фактического значения вверху.

    В обоих случаях отображаются обе диаграммы, но потребуется три выражения для создания отдельной диаграммы, один параметр для одного измерения вернет ноль. В случае, если фактическое значение точно равно цели, будет отображен столбик над целью, подцель и цель будут в нуле.

    Необходимые выражения:

    Under Target/ под целью
    if(sum(Actual) >= sum(Target), 0, sum(Actual))

    Target/цель
    if(sum(Actual) >sum(Target), sum(Target),
    if(sum(Actual) Over Target/над целью
    if(sum(Actual) >sum(Target), sum(Actual) — sum(Target), 0)

    Таким образом, в QlikView и Qlik Sense создаются различные выражения, но синтаксис идентичен.

    Скорее всего, у вас будет какой-то анализ множества в вашем выражении, возможно, чтобы показать отклонение только в течение определенного периода или только привести фактические значения, где есть цель, но этого кода достаточно для нашего примера.

    Стилизация диаграммы

    Для получения диаграммы вам потребуется превратить её в гистограмму стопкой. В QlikView это можно сделать через вкладку Стиль, а в Qlik Sense это можно найти во вкладке Вид и Представление. Скорее всего, вам захочется сделать диаграмму горизонтальной, так как это более логичное использование для отображения цели. Также может потребоваться убедиться в том, что ваши условные обозначения выглядят приемлемо. В QlikView достаточно просто добавлять цвета, так как данное приложение применяет три первых цвета из карты цветов к вашим трем выражениям. Используйте GUI (графический интерфейс пользователя) во вкладке Цвета для получения диаграммы следующего вида:

    Тем не менее, в Sense отсутствует возможность применения различных цветов для разных выражений в ваших диаграммах. По моему мнению, это основной недостаток, который, надеюсь, будет исправлен в последующих версиях. Позже в этом посте я опишу, как с этим работать, но сейчас наша диаграмма будет иметь такой вид:

    Замечу, что в таком случае «зависший» текст, полученный этой диаграммой, не идеален, так как мы разбили фактическое значение на части. В QlikView можно отключить эту функцию (во вкладке Представление), но необходимо оставить ее в Sense.

    Разница в процентном соотношении

    Сейчас показываются абсолютные значения, но мы может захотеть увидеть разницу в процентном соотношении. Это легко выполняется путем деления каждого выражения на цель. Окончание целевого столбика в таком случае будет на единице (пока оно составлено из одного или двух столбиков), затем все больше и больше целей будет выходить за его пределы.

    Выражение для второй диаграммы будет выглядеть следующим образом:

    Under Target
    if(sum(Actual) >= sum(Target), 0, sum(Actual))
    / sum(Target)

    Target
    if(sum(Actual) >sum(Target), sum(Target),
    if(sum(Actual) Over Target
    if(sum(Actual) >sum(Target), sum(Actual) — sum(Target), 0)
    / sum(Target)

    Стоит отметить, что потребуется изменить формат номера для всех выражений. В QlikView это делается через вкладку Номер (отметьте галочкой процентное соотношение в нижней части списка), а в Sense – это можно найти во вкладке Данные — Меры — Формат чисел.

    Наша диаграмма Sense для процентного соотношения будет выглядеть следующим образом:

    Сочетание этих двух визуализаций может отобразить различия между тем, как отдельные области выступают против цели, а также друг против друга, что не могут показать в явном виде две отдельные диаграммы. Другим преимуществом этой пары диаграмм является то, что диаграмма процента разницы выступает в качестве ключа к другой, что делает ее абсолютно прозрачной, поскольку фактические столбики относятся к целевым.

    Если вы следовали такому способу в QlikView, теперь у вас должны быть две диаграммы, которые вы можете продолжать использовать. Если же вы используете Sense, у вас есть две диаграммы со счетчиком интуитивных цветов. Существует исправление, хотя…

    Обходное решение для цветов гистограмм в QlikSense

    Как уже упоминалось ранее, мы не можем выбрать различные цвета или цветовые выражения для каждого выражения в нашей диаграмме Sense. Однако мы можем создать цветовое выражение относительно наших параметров.

    Одним из трюков, который можно использовать, является загрузка островков данных с тремя столбиками так, что получится гистограмма с двумя параметрами. Вместо этого мы можем задать второй параметр в коде с помощью функции Valuelist. Как и функция Aggr, в сущности она возвращает набор записей, но на этот раз это набор записей, который мы ввели.

    Повторите первую пару шагов, чтобы получить новую диаграмму с параметром Области, а затем добавьте второй параметр с помощью кнопки Добавить данные и вставьте этот код:

    =ValueList(‘Under Target’,’Target’,’Over Target’)

    Предлагаю поставить пробел в поле Метка, чтобы подавить любое другое появляющееся условное обозначение.

    Теперь мы можем получить диаграмму либо с одним параметром и несколькими выражениями, либо с двумя параметрами и одним выражением (это также относится и к QlikView). Таким образом, все три части наших сложенных столбиков должны быть получены из одного выражения, которое выглядит следующим образом, добавлены с помощью кнопки Добавить данные:

    if(ValueList(‘Under Target’,’Target’,’Over Target’) = ‘Under Target’,
    if(sum(Actual) >= sum(Target), 0, sum(Actual)),
    if(ValueList(‘Under Target’,’Target’,’Over Target’) = ‘Target’,
    if(sum(Actual) >sum(Target), sum(Target),
    if(sum(Actual) sum(Target), sum(Actual) — sum(Target), 0))))

    Настройте условные обозначения для нового выражения, как только закончите. Результат – диаграмма, не отличающаяся от оригинальной диаграммы Sense.
    Чтобы применить цвет, нам нужно перейти в меню Внешний вид и выбрать Цвета и условные обозначения. Здесь выберите выражение из выпадающего меню и отметьте Выражение -Цветовой код.
    В окне функции необходим следующий код:
    Pick(Match(

    ValueList(‘Under Target’,’Target’,’Over Target’),
    ‘Under Target’, ‘Target’, ‘Over Target’),
    rgb(255,100,100), rgb(120,120,120), rgb(100,200,100))

    Здесь используется та же функция Valuelist, которую мы использовали для вычисленного параметра. Когда мы говорим о ней в выражении цвета, она вернет значение для столбика, на цвет которого мы смотрим в настоящее время. Кроме того, в данной функции очень полезны комбо Pick и Match: функция Match возвращает значение от 1 до 3 (в зависимости от текущего параметра) и выбирает один из трех цветов. Вы также можете захотеть отображать результаты разными цветами — но зато вы получите идею.

    Аналогичные методы использования вычисляемого параметра и нескольких выражений в одном с оператором «если» могут использоваться и в QlikView для решения ситуаций, когда необходимо одновременно применить несколько выражений и параметров.

    После применения этого кода наша диаграмма Sense должна выглядеть также разумно:

    Создание версии изменения процента этой диаграммы на самом деле проще, чем реализация предыдущей диаграммы, так как не имеет значения, какая часть списка значений в настоящее время рассматривается, все результаты должны быть разделены на цели. Таким образом, выражение для этого будет выглядеть следующим образом:

    if(ValueList(‘Under Target’,’Target’,’Over Target’) = ‘Under Target’,
    if(sum(Actual) >= sum(Target), 0, sum(Actual)),
    if(ValueList(‘Under Target’,’Target’,’Over Target’) = ‘Target’,
    if(sum(Actual) >sum(Target), sum(Target),
    if(sum(Actual) sum(Target), sum(Actual) — sum(Target), 0))))
    / sum(Target)

    Опять же в формат номера и условных обозначений должны быть внесены изменения для отображения числа в нужном формате и для того, чтобы было ясно, что показывает диаграмма.

    Примеры для загрузки

    Как и многие из примеров, которые мы создали, приложения, сопровождающие этот блог, можно загрузить в сообществе Qlik. Есть следующие версии для Qlik Sense и QlikView:
    QlikView
    Qlik Sense

    Если данная статья оказалась полезной, как и примеры, которые создаются, пожалуйста, найдите время, чтобы оставить нам свои лайки и комментарии в сообществе Qlik – это действительно помогает распространить то, что мы делаем среди множества людей.

    Найти решение у бизнес-партнера QlikTech (QlikView) в России.

    Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

    75 queries in 0,275 seconds
    Website nonton bokep jepang