FAQ по техническим вопросам о Qlik Sense/Qlik View часть 2

Q: прошу помощи,
у меня нет опыта, поэтому мои вопросы могут показаться неадекватными.
Сценарий -1:
1. есть данные которые нужно визулизировать анализировать и все такое, допустим объем данных 3 гигабайта
2. допустим что для обработки данных объемом 3 гигабайта в оперативной памяти, нужно 8 гигабайт оперативки
3. Потом вдруг понадобилось обработать объем данных 5 гигабайт
Вопрос, как поведет себя qlik sense? он не сможет обрабатывать 5 гигабайт? сможет обрабатывать но начнут притормаживания? qlik sense будет использовать что-то типа файла подкачки на диске?
Сценарий-2:
1. Есть БД под управлением Oracle, в этой БД содержится сотни милионов записей фактов, каждая запись имеет дату.
2. пользователь который не имеет технической квалификации по работе с системой, должен выбирать в протсом интерфейсе период данных за которое он хочет анализировать данные
вопрос — в qlik sense есть возможность натсроить интерфейс/права так чтобы учитывалась период данных при загрузке данных из БД в Qlik

A:З гигабайта в источнике в процессе создания приложения на QLIK-продуктах чудесным образом превращаются в существенно меньший объем. 🙂
Приложения Qlik Sense и Qlikview работают в оперативной памяти, отсюда и требования к ее объему, чтобы все работало 🙂
По доступам, на официальном форуме эта тема довольно долго обсуждалась. Решения есть.

Q: Просмотр профиля

Планируем переход на продукты Qlik. Есть несколько вопросов
« : Ноябрь 01, 2015, 12:02:23 am »
Добрый день
Наша Компании рассматривает варианты перехода на решения от Qlik. Хочу уточнить несколько технических вопросов, важных для нашей инфраструктуры:
1) Существует продукт для трансляции дашбордов в интернет с наших локальных серверов (https)?
Если существует, то по принципу облачных вычислений на серверах Qlik, или на локальных серверах клиента?
2) Каким образом производится администрирование учетных записей пользователей и уровень доступа к данным?
3) Продукты от Qlik работают с источником кубом табличной модели MS SQL Analysis Services (SSAS)?
Буду очень благодарен за помощь и советы

A: Таким продуктом могут быть системы Qlik (как QlikView, так и Qlik Sense).
Для трансляции дэшбордов в интернет с локальных серверов (https) достаточно стандартного функционала QlikView, при этом нет необходимости дополнительных настроек и разработок, поскольку система работает в стандарте HTML5.
Дополнительно к этому существует возможность размещения и в облаке (для Qlik Sense).
Администрирование удаленных учетных записей производится через Qlik Management Console, где определяется уровень доступа к приложениям и элементам самого документа (визуализациям: диаграммам и графикам).
Дополнительно можно использовать Section Access через скрипт в QlikView, который позволяет разграничить права доступа к данным для пользователя или группы пользователей.
Продукты Qlik напрямую не работают с MS SQL Analysis Services, но могут брать данные из модели, на основе которых генерируется табулярная модель.

Q: А это означает, что вы можете начать свое лето за увлекательным изучением Qlik Sense Desktop и его 4 новых функций, включая следующие.
1. Интеллектуальная загрузка данных. Подключение источников данных на основе предложенных вариантов имен поля и значений данных.
2. Интеллектуальное сжатие данных. Миллион или даже миллиард точек данных? Нет проблем с обновленными точечными данными.
3. Печать и экспорт. Простая печать объектов и листов как PDF или изображения.
Но это всего 3 функции? Нет, есть еще одна!

Теперь вы можете обогатить содержимое и аналитику с помощью Qlik DataMarket. Это предложение «данных как услуги» (DaaS) обеспечивает доступ к готовым к использованию внешним источникам данных, таких как данные о погоде и курсе валют, и доступно бесплатно непосредственно в Qlik Sense Desktop.

A: Работа с источниками данных стала проще, не пойму роль диспетчера данных. Измерения и меры все равно прописываются из просмотра.
В целом — отлично!
Data Market куцая в бесплатном варианте, но может и пригодится. Погодных данных по России нет.

Q: Подскажите пожалуйста касательно опции os events log path (рисунок ниже) , запускали макросы и форматировали как по инструкции,какие-то данные загружало,но не совсем понятно как меняется картина в общем.,т.е. какие уникальные данные можно получить от журнала событий ОС .Дает ли это возможность использовать анализ не только для клика .

A: Вопрос не в приложении. Оно лишь загружает данные и отображает их своими объектами.
То же самое можно делать в различных системах. С разным уровнем сложности и своими особенностями.
Анализ событий (логи) в системах сделан более менее похоже. Как правило, в каждом случае есть возможность либо формировать логи в удобный для Qlikview формат либо они уже в текстовом формате.
А если какие-то данные уже из приложений надо выгружать для других систем.
Ну для начала попробуйте самый простой способ:
store * from … into file.csv (txt);
Можно параллельно с сохранением QVD файла делать и текстовую копию, удобно для отладки в работе с небольшими данными.
Q: Добрый день все!Вопрос следующего характера: возможно ли ивенты windows поместить в отчеты от Клика?Если да,то примерно каков ход действий?

A: https://community.qlik.com/docs/DOC-4307#comment-19886
Задача больше не по клике а к сисадмину. Требуется настроить логирование в удобном виде.
Либо конвертация evtx в csv, либо в MSSQL, а дальше «как по маслу» 😉

Q: Имеется очень легкий вопрос, на который, пока не нахожу ответа.

Как вывести в txt-файл лог загрузки «Script Execution Progress»

A: флажок в настройках документа «Создание файла журнала» решит проблему.
Если требуется отдельный лог на каждый запуск, то ставим «галочку» в опции — «Отметка времени в имени файла журнала».
Файлы будут в той же папке, что и приложение.

Q: Коллеги, задался вопросом. А возможно созданное приложение встроить на сайт?
Как я понимаю что бы встроить Qlik View на сайт, необходимо обладать серверной лицензией и собственно сервером. А вот как дела обстоят с Qlik Sense? Вроде где-то читал, что он специально сделан, что бы облегчить функции интеграции с web?

A: Когда запускаешь Qlik Sense, даже не локалке, уже запускается веб сервер.
Проверьте http://localhost:4848/hub

Q: Добрый день коллеги:
1. Создал приложение.
2. Загрузил его в cloud
3. А вот просмотреть его как пользователь не могу, постоянно пишет http://prntscr.com/7gzjin

Вопрос: что делать?
Пробовал со всеми последними версиями браузеров, не работает.

A: Облако еще только-только начинает работать.
Обращайтесь в облачную поддержку.

Q:
Не подскажете как можно подключиться в клике по sftp?

A:
Но каталоги с FTP можно подключить как сетевые диски и, теоретически, использовать как обычно.
Но с учетом того, что быстродействие таких соединений не всегда радует, я бы рекомендовал синхронизацию папок сервера с локальными папками, например через WinSCP.

P.S. Полезные ссылки
http://ramzes.ws/blog/synchronize-ftp
http://lpf.maxsite.com.ua/use-winscp
http://winscp.net/eng/docs/lang:ru

Q: Подскажите, какой аналог DateDiff есть в клике?

A: Есть такой вариант,
DateDiff в составе библиотеки функций для Qlikiview и Qlik Sense
Базовый набор функций даты и времени в документации

Q: В таком случае — синхронизация папок.

Это что такое?)

A: Кстати, встречался с использованием Яндекс-диска для синхронизации между удаленными станциями.
Вот уж чего не следует делать, так использовать такие сервисы в работе.

Q: Добрый вечер. Не подскажите ли возможно в qlikview прослеживать изменения данных, используемых в программе, разными пользователями. В случае, например, если первоначальный файл, используемый в qlikview, корректируют одновременно 2 работника?

A: Можно информацию поподробнее:
— состав QlikView (локальная, сервер, Publisher).

Q: Доброго всем времени суток. достался в наследство qlikview. первоначально машина была в рабгруппе, после того как завели в домен, не работают отчеты у пользователей. Подскажите как победить проблему. http://img.flashtux.org/img13350c011ff4x89482e3e.png

A: Скорей всего, машинка с бесплатным вариантом Qlikview.
Сменили учетную запись, программа решила что ее поставили заново и включила ограничения использования. Почитайте в документации нюансы по поводу использования бесплатной версии.
И судя по всему, вы или до вас уже использовали 3 попытки. Осталась одна попытка и риск вообще не открыть приложения.
В этой ситуации следует либо решить вопрос с лицензиями (т.е. купить), либо создать приложения заново.
Перенос приложений много времени не займет, главное чтобы старое открывалось.
Скрипт копируется через текстовый файл, объекты создаются заново. Если, конечно же, не очень много хитрой графики и дизайна.

Q: Инструменты разработчика Qlikview/Qlik Sense — Notepad++

A: Со временем, даже у начинающего разработчика накапливается набор различных скриптов обработки и подготовки данных. Работать с ними в Qlikview не очень удобно, порой приходится держать открытыми несколько сценариев, компонуя новое приложение.
Можно использовать обычный текстовый редактор и выгрузку в qvs-файлы, но без расцветки работать уже непривычно.
Отличным решением проблемы служит бесплатный редактор Notepad++ и библиотека синтаксиса Qlikview.

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

FAQ по техническим вопросам о Qlik Sense/Qlik View часть 1

Q: Вам нужна постоянная авторизация при запуске Qlik Sense?

A: Qlikview и Qlik Sense имеют одинаковое ядро, и должны одинаково выполнять скрипты.
Если Qlik Sense и Qlikview одинаково будут выпадать в ошибку при выполнении скрипта — ошибка в алгоритме, и новая версия Qlik Sense вам не поможет. Если же в QV все отработает без ошибок — проблема в Qlik Sense.

Версии, предоставляемые разработчиком для всех и для клиентов, могут отличаться.

Q: Помогите пожалуйста!!!
После обновления Qlik Sense Desktop пытаюсь создать сводную таблицу, через какое-то время после работы вылетает ошибка «Внутренняя ошибка подсистемы».
Сводная таблица переходит в режим обновления с кнопкой «Отменить», и на этом всё. Никакие дальнейшие манипуляции с приложением не дают работать, хоть удаляй и настраивай заново. Сначала это было на старых приложениях (которые настраивал до обновления), настроил новое, тоже самое.

A: У меня подобная ошибка была из-за линейного графика. В свойствах линейного графика, в разделе Дополнения-Обработка данных я снял галку Включить нулевые значения и ошибка пропала.

Скорее всего эта ошибка из-за нулевых, минусовых, пустых значений.

Q: Помогите решить следующий вопрос:
При открытии файла программа выдает сообщение:

Данный файл был опознан как Ваш собственный. Однако необходимо обновить ключ в документе, чтобы отразить изменения в вашей копии Personal Edition с момента создания этого документа.

Документ будет обновлен и загружен без данных. После окончания операции, пожалуйста, СОХРАНИТЕ документ и выполните загрузку данных.

И теперь файл ничего не отображает. Как все вернуть обратно?

A: Если у вас выходит такое сообщение, то это значит, что на этом компьютере уже открывали файл с того компьютера и использовали как минимум одну попытку восстановления.
Т.о. все приложения с того компьютера должны открываться на вашем после сохранения и обновления данных.

Если обновление данных не произошло, но скрипт доступен — проверяйте процесс загрузки данных.
В случае, когда уже нет попыток восстановления а скрипт надо открыть — используйте Qlik Sense.
В последней версии есть и конвертер приложений Qlikview, который преобразует измерения, объекты и выражения в основные объекты нового приложения Qlik Sense.

Q: Порекомендуйте, пожалуйста, как лучшего всего обновить QVS
Сейчас стоит 12.00, планирую накатить 12.10

Вопрос в том, каким образом оставить возможность «откатить» все назад, в случае каких- либо проблем.
QVS развернут на виртуальном Windows сервере.
Бэкапить всю виртуалку или можно ограничиться C:\Program Files\QlikView ?

Может у кого-то был опыт — ключи лицензий нормально наследуются при обновлении?

A: Я обычно такие операцию «репетирую» на копии. А в случае с промышленным решением, которое находится в работе, считаю, это просто обязательным этапом.
Разверните сервер локально и протестируйте обновление на нем.
И проблем не будет.
Насчет отката с версии 12.10 на 12.00 — не уверен.

Q: Возник такой вопрос. Можно ли перенести на сервер, приложение с Personal Edition, созданное на локальной машине, так чтобы все данные сохранились. Если можно, то каким образом?

A: Если у вас сервер с лицензией, то да. А вот в обратную сторону (открыть не своё приложение, если 4 попытки закончились), не получится.

Q: Есть файл qlik который загружает все необходимые параметры из базы конфигурации, формирует скрипт загрузки, загружает данные из различных источников, пишет лог загрузки, и выгружает все таблицы в .qvd.
Так как таких физических мест формирования данных довольно много (>20) то ставить полный qlik особо не хочется и принято решение компилировать .exe и дальше с ним работать. Все было нормально пока не понадобилось контролировать лог загрузки. Дописал функцию экспорта лога в формате .xml в скрипте загрузки в параметрах разрешил чтение и запись в БД. Ну и соответственно в qvw все работает на ура. формируется, пишется и логируется. После компиляции в exe и запуска приложения, в момент начала загрузки появляется сообщение «qmem:///ИмяФайла.qvw contains an incorrect path.» и после нажатия «Ок» предлагается сохранить данный файл в qvw. и уже не важно сохранишь или отменишь сохранение дальше пойдет нормальная загрузка.
————
Может кто подскажет как побороть данное сообщение аля Application.DisplayAlerts = False

A: Привет, а если не exe-шник а просто десктопную версию ставить?

Q: Можно ли в планировщике настроить следующий таск:

Перед обновлений данных приложения сохранить бэкап необновленного приложения в определенное место на диске.

A: Можно написать powershell/bat/vbscript/jscript скрипт, который копирует текущую версию приложения в backup. Затем создать задачу в планировщике Windows на ежедневный запуск данного скрипта.

Q: Помогите решить задачу:
Есть дерево папок в которые систематически добавляются файлы и после обработки удаляются
Пример папок:
..\Регион 1
..\Регион 2
..\Регион 3
и тд.
Но так как не всегда все папки содержат файлы скрипт соответственно выдает ошибку о том что файл для обработки не найден
Как обрабатывать только папки содержащие файлы исключая пустые папки из загрузки?

A: Если у вас Desktop, то меняем параметр на StandardReload=0 в файлике Settings.ini. Находится он C:\Users\<...>\Documents\Qlik\Sense

Если сервер, то QMC-Engines, там заходим в настройки нашего «engine», там Advanced, убираем галочку Standard Mode, перезапускаем службу.

Q: Мы недавно обновили QlikView сервер с 10 версии на 11 и все отчеты стали заметно дольше выгружаться, очень заметно тормозить. Отчеты не переписывались. Может кто сталкивался и знает в чем может быть дело. Или есть какие то общие рекомендации по оптимизации кода. Переписать какие то функции, которые справлялись в 10 версии, но в новой тормозят.

A: посмотри в англоязычном сообществе. Может и обсуждалось.
У меня с переходом на десктопе с 10 на 11 был один глюк. Перестали работать некоторые скрипты на целероне.

Q: Предлагаю обсудить вопрос использования продуктов Qlik.

Мой вариант ответа под номером 5.
Все-таки Qlikview удобнее для написания скрипта и отладки моделей. Вот только не пойму — быстрее от того что привычнее лично мне или действительно скорость разработки в Qlik Sense ниже чем на Qlikview?

A: Интересное мнение. Если 1С-ка файловая- возможно и соглашусь с тем что данные вытянуть быстрее средствами 1С, но в случае с SQL-базами все как раз наоборот. Средствами 1С сделать аналитику уровня QLIK Невозможно!!!

Q: подскажите пожалуйста как можно ускорить работу приложение qlikview. У меня в приложение много записей, тормозит сильно сводная таблица и некоторые диаграммы. Долго перевыбирает данные.

A: На эту тему уже много обсуждений есть в инете.
Суть такая — сводные сами по себе сложные объекты. А если в них еще и выражение с непростым синтаксисом (набором процедур), то при любом обновлении состояния окружения происходит перерасчет всех выражений.
Начинайте оптимизацию с выражений. И для начала сводную просто уберите, «поиграйтесь» на простой таблице. Если возможно, уберите расчеты на уровен скрипта, оставив в приложени простые агрегатные выражения и т.д.
Здесь все индивидуально, может просто планку памяти вставить и все решится?

Q: Есть приложение, в планировщики поставил, чтобы оно обновлялось каждые 15 минут. Мне нужно(если такое возможно), чтобы планировщик не обновлял данные ночью, т.е. например надо, чтобы он загружал данные с 8:00 до 20:00 каждые 15 минут, а остальное время не обновлял данные. Если так можно сделать, подскажите пожалуйста как. Заранее спасибо.

A: Если организовано через планировщик винды то так:
ставите расписание с повтором каждые 15 минут и запуском vbs скрипта, в котором проверяете текущее время. Если оно в нужном промежутке, то запускаете Ваше приложение на выполнение.

Q: Возможно ли из QlikView и QlikSense экспортировать таблицы,переменные,диаграммы в Word с помощью/без помощи Н-принтинга?

A: Доводилось тестировать NPrinting в cвязке с QlikView, можно выгружать и таблицы и диаграммы в Word, причем все интуитивно понятно (набросать шаблон, запланировать обновление, при необходимости задать адресатов. и в нужное время будут у вас отчеты заданного формата с актуальными данными). Без NPrinting сам не пробовал, но думаю макросы помогут, если есть умельцы такой макрос написать, по крайней мере когда-то натыкался на выгрузку в Power Point, а выгрузка в Excel точно освящена на community.
Касательно Qlik Sense утверждать не берусь, c NPrinting думаю все будет без проблем, а вот насчет выгрузки без него ничего утверждать не стану, пока не доводилось сталкиваться с такими задачами.

Q: При обновлении документа в QlikView через таск менеджер, при сохранении документ сваливается с ошибкой, если в этот момент документ открывается, считывается пользователем. Приходится по новой запускать обновление, а это занимает много времени. Может кто знает как это исправить?

A: Сделайте отдельный документ для обновления qvd-файлов.
А обновление приложения с визуализацией доверьте пользователю.

Q: Подскажите, пожалуйста, в чем может быть причина, что не освобождается память, если даже закрыты все документы QlikView и никаких расчетов не происходит. Вижу, что занято 80 % памяти, при этом все держит QlikView.

A: Замечал, что exe-файл после закрытия QlikView может продолжать существовать на сервере или на компьютере в фоновом режиме. Как вариант, можно убить процесс, через диспетчер задач. Но с этим нужно быть внимательным! 🙂

Q: помогите пожалуйста,
как расчитать объем оперативной памяти который нужен для Qlik Sense.
если известен количество строк модели, количество столбцов, и объем одной записи.
к примеру 20 столбцов
40 млн записей
и одна запись весит 2кб

A: Самый лучший способ — эксперимент.
Сгенерируйте тестовую таблицу, увеличивая число записей фиксируйте объем занятой памяти.
Но учтите, что еще будет визуализация, которой тоже надо где-то «крутиться».

Q: Коллеги не могу войти в qlikcloud.com, может кто вкурсе

A: проверь почту.
Была рассылка по поводу изменения процедуры входа в Qlik Sense Cloud.

Q: Подскажите,пожалуйста, есть ли возможность обрезать модель в клик сенсе по текущим выборкам и как это сделать? Нужно оставить данные только за один год

A: Я так понял, вас интересует наличие функции как в Qlikview — «Сокращение данных»?
На таком же уровне, увы — нет.
Но динамическое сокращение данных на основе секции доступа работает и в Qlik SENSE.

Q: Поделитесь опытом, может быть кто-то сталкивался с подобными задачами.
Хотим интегрировать QlikSense и базу данных Oracle, с прикрученной к ней системой полнотекстового поиска Sphinx.
В идеале сценарий следующий:
1. Прямо в веб-приложение Qlik добавляется поисковая панель (поисковая строка и некоторые настраиваемые параметры поиска)
2. Формируем в этой панели поисковый запрос, нажимаем «найти»
3. Sphinx проводит поиск в БД и возвращает IDшники из таблицы фактов обратно в Qlik.
4. Дальше работаем с этой «выборкой» стандартными способами (накладываем фильтры, выбираем периоды и пр.)
Подскажите, есть ли какие-то ограничения со стороны Qlik и его API для такого сценария
Может еще какие-то подводные камни?

A: Вроде бы схема возможна в реализации.
Но я бы все-таки начал со стандартных механизмов фильтрации в Qlikview и Qlik Sense.

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!

FAQ по справочным материалам Qlik Sense/Qlik View

Q: Часто возникают вопросы, где скачать учебники, документацию и т.п. по Qlikview.

A: Все просто:
1. Читаем руководство «Создание приложений QlikView» на сайте http://solutions.atkcg.ru/manuals
2. Смотрим видео «Qlikview за 8 шагов» на хостинге ютуб.
3. Изучаем help.qlik.com и скачиваем набор документации в pdf-формате.
4. С сайта qlik.com скачиваем дистрибутив (включая учебник с примерами).
5. Устанавливаем и выполняем уроки по учебнику.
Ищем ответы на вопросы в документации, сообществах и если ответ не найден, тогда задаем вопросы.
Хороший набор видеороликов на канале Practical-qlikview от Mark O’Donovan, автора ряда обучающих книг по Qlikview и Qlik Sense
http://www.youtube.com/user/practicalqlik
Рекомендую всем
Сайт автора — http://www.techstuffy.com
Книга «Discovering Qlikview» Tom Meers
Книга «Qlikview 11 Developer’s Guide» B. Harmsen
Книга «Qlikview Scripting» Matt Floyd

Q: Каким образом рассчитать оборачиваемость и показатель GMROI в QV?
Может есть ссылка на справочник по работе с функциями?

A: Описание функций, как обычно, в документации.
Специальных функций под эти цели в Qlikview и Sense нет.
Можете подготовить пример для обсуждения?

В целом, по теме — ничего сложного нет.
Если хромаем в теории, пользуемся поисковиком. Лично мне нравится этот сайт
А дальше уже переводим в формулы, согласно сформированной модели и сверяемся с контрольным примером, заранее и достоверно рассчитанным.

Q: Подскажите, пожалуйста, где можно купить книгу QlikView 11 for Developers ?
И какие еще книги можете посоветовать?

A: Плюс официальный сайт со справочными материалами.
http://help.qlik.com

Q: Кто-то проходил аттестацию по QlikView? Она проходит только на английском языке? Может есть у кого-то примерные вопросы?

A: На qlik-daily на эту тему:
http://blog.atkcg.ru/kak-projti-sertifikaciyu-qlikview-11-developer-sovety-byvalogo/
http://blog.atkcg.ru/sertificiruemsya-na-administratora-qlik-sovety-byvalogo-chast-2/

Q: Давно заметила за собой такой недостаток, что очень некрасиво пишу формулы и непонятно остальным оформляю скрипт загрузки. Сейчас стала стараться писать его правильно, но все равно не до конца понятно и красиво. Есть ли установленный правила оформления скрипта и больших выражений?Где их можно почитать?

A: Под сетами понимаются выражения задающие условия отбора?
Код:
{<[Календарь ПериодNum]={$(=max([Календарь ПериодNum]))}>}
В оформлении никакого криминала не вижу.
Но есть пара замечаний, личных, не базирующихся на каких-либо стандартах.
1. Именование полей, смешанные названия типа [Календарь ПериодNum]. Легче работь с моделью где все поля именуются по одному принципу и желательно на одном языке. Смешанные названия отнимают время на понимание и ввод с клавиатуры.
2. Расчеты в выражениях. Следует помнить, что при каждом изменении выборки происходит перерасчет всех выражений в приложении. Я бы рекомендовал избавиться от выражения:
Код:
((P_RATE)/100)*P_OUT_PORTF_VAL)/1000
переместив эту задачку в скрипт подготовки данных.

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
FAQ по скрипту Qlik Sense/Qlik View часть 7

Q: Вот уже 3й день борюсь с QlikView и пытаюсь придумать максимально эффективный метод формирования таблицы.
Итак, изначально есть QVD таблица, имеющая чуть более 600к записей, следующего типа:

triggerid time value
46397 2015-02-20 11:23:21 0
46397 2015-02-20 11:11:22 1
46397 2015-02-12 10:35:21 0
47654 2015-02-20 11:23:48 0
47654 2015-02-20 11:10:48 1
47654 2015-02-15 12:15:48 0

Нужно для каждого значения time, принадлежащего определенному triggerid, найти время следующего события, т.е. минимальное время из больших данного для данного triggerid.

Нужно получить следующую таблицу:

triggerid time value nexttime
46397 2015-02-20 11:23:21 0 null
46397 2015-02-20 11:11:22 1 2015-02-20 11:23:21
46397 2015-02-12 10:35:21 0 2015-02-20 11:11:22
47654 2015-02-20 11:23:48 0 null
47654 2015-02-20 11:10:48 1 2015-02-20 11:23:48
47654 2015-02-15 12:15:48 0 2015-02-20 11:10:48

Такие задачи обычно решаются через join, что я, собственно, и сделал.
Работает отлично, если я в запросе укажу небольшое кол-во triggerid. Однако при большом кол-ве, ОЗУ достаточно быстро забивается до отказа.

Реализовал загрузку следующим образом:
Код:
tmp:
LOAD
triggerid,
time as DownTime
FROM Table_events.qvd (qvd);

Left Join
LOAD
triggerid,
time as UpTime
FROM Table_events.qvd (qvd);

STORE tmp into Temp.qvd (qvd);
DROP Table tmp;

tmp:
LOAD
triggerid,
DownTime,
min(UpTime) as UpTime
from Temp.qvd (qvd)
Where DownTimeA: А если просто отсортировать список по тригерам и времени, и формировать новое поле с условием и peek()
Ведь отсортированный список подразумевает что следующее значение поля time для одного и того же тригера будет ближайшим минимальным из всего ряда значений времени для этого тригера.

Q: Добрый День! Подскажите как преобразовать числовое значение даты в секундах ( linux время) в нормальный формат, есть ли такая функция?

A: Дата — целое число, время — значение десятичной дроби, следовательно. имея метку времени, т.е. число с дробью для получения корректного значения даты требуется округлить в меньшую сторону.
Функция Floor()
Как вариант, можно использовать daystart()

Q: Возникла следующая задачка, не пойму как ее реализовать. Подкиньте, пожалуйста идейку.
У меня есть следующие поля:
— наименование акции
— даты проведения
— продажи в каждую дату
Пример тут https://yadi.sk/i/UKxngxf4ed6Ga

Что бы хотелось:
1. Подсчитать сколько дней длиться каждая акция. Например, 3 или 4 дня.
2. Для каждой акции проставить номер дня акции — 1й день, 2й день, 3й день и т.д. (может быть до 15 дней)
3. И в завершении сделать табличку вида:

Наименование акции 1й день 2й день 3й день и т.д.
Prior 68% 16% 14%
MM-dadak 75% 16% 8%
Лесная сказка 65% 19% 15%

A: Самое простое решение — формирование поля для хранения порядкового номера дня акции в скрипте.
Например:
Код:
tmp1:
LOAD * INLINE [
Акция,Дата,Продажи
Prior,01.02.2014,3000
Prior,02.02.2014,2500
Prior,03.02.2014,1000
MM-dadak,15.04.2014,5000
MM-dadak,16.04.2014,4000
MM-dadak,17.04.2014,2000
MM-dadak,18.04.2014,500
Лесная сказка,20.05.2014,3000
Лесная сказка,21.05.2014,1000
Лесная сказка,22.05.2014,300
];

NoConcatenate
LOAD *,
if(Акция<>Previous(Акция),1,Peek(ДеньАкции)+1) as ДеньАкции
Resident tmp1
Order by Акция, Дата;
DROP Table tmp1;

Смысл в том, что мы упорядочиваем таблицу по акциям и датам и сравнивая текущее и предыдущее значение поля Акции определяем запись для новой акции и группы дат. Проставляя 1 как начало счетчика, далее подсчитываем записи по каждой акции.
Но, если есть разрывы в датах, скажем за 15.04 сразу 17.04 это решение придется модифицировать в зависимости от постановки задачи.

Q: Подскажите, пожалуйста, как сделать следующий расчет в скрипте? Во второй таблице рассчитываю сумму возврата, используя [Цена продажи,руб.] из первой таблицы. Или так нельзя?
Сейчас выдает ошибку при загрузке скрипта. Пример:

Заказы:
LOAD [№ заказа],
[ID товара],
[Кол-во товара в заказе,шт.],
[Цена продажи,руб.],
[Кол-во товара в заказе,шт.]* [Цена продажи,руб.] as [Сумма продажи,руб.]
FROM
[C:\Users\volodina.i\Desktop\QV Mamsy v.1 (янв-фев)\Заказ-товар.xlsx]
(ooxml, embedded labels, table is [Заказ-товар]);

Возвраты:
LOAD [Дата возврата],
[Кол-во возврата,шт.],
[№ заказа],
[Кол-во возврата,шт.]*[Цена продажи,руб.] as [Cумма возврата,руб.]
FROM
[C:\Users\volodina.i\Desktop\QV Mamsy v.1 (янв-фев)\Возвраты.xlsx]
(ooxml, embedded labels, table is Лист1);

A: Скорей всего, в заказах у вас комбинация уникальная [№ заказа], [ID товара].
В возвратах таких комбинаций может быть несколько.
Следовательно, по примеру piton грузим сначала таблицу возвратов, к ней присоединяем таблицу заказов. В итоге получим для каждой строки возврата сведения из строки заказов.

Без обработки в скрипте возможно получить сведения и выражениями, но только если построенная модель данных это позволит сделать.

Q: Есть задача.
Имеем таблицу календарь, и таблицу с данными:
Магазин,
Товар,
цена,
Начало цены,
Конец цены,
Далее надо сделать сводную таблицу(Chart) где строки будут магазин, товар. Столбцы будут дата из календаря(Аналитик хочет видеть цену на каждый день). В пересечении на каждую дату требуется вывести цену где, «Начало цены» больше или равно «Даты» и «Конец цены» меньше или равно «Даты».

Я вижу только решение объединить две таблицы вместе через left join. И при повторной обработки убрать записи через Where. Но таблица получается очень тяжелая. Есть ли другой способ не объединяя таблицы?

A: День добрый, посмотрите в документации описание и примеры по функции intervalmatch().

Q: Только начал использовать продукт, поэтому извините за возможно очевидный вопрос.
Загружаю данные из SQL Server через OLE DB. В одной из таблиц имеется поле с датой.
Эта дата никак не хочется распознаваться, как дата(
Встроенные функции, типа date(), нельзя применять в OLEDB запросе.
Пересохранить данные в файл, забрать оттуда и сконвертировать функцией — мне не нравиться это решение.
Подскажите пожалуйста верное решение.

A: Привет, а предварительную загрузку Load используете?
к примеру:
load date(datefield) as [Дата], …;
select sql from oledb;

Q: Возникла задача, для упрощения создал ограниченный пример. Есть мероприятия, у каждого мероприятия есть дата начала и дата окончания. Есть календарь. В календаре выбирается дата. Вопрос — как отфильтровать в таблице те мероприятия, у которых дата начала меньше выбранной даты, а дата окончания мероприятия больше выбранной даты. Во вложении картинка. Код приложения:

SET ThousandSep=’ ‘;
SET DecimalSep=’,’;
SET MoneyThousandSep=’ ‘;
SET MoneyDecimalSep=’,’;
SET MoneyFormat=’# ##0,00р.;-# ##0,00р.’;
SET TimeFormat=’h:mm:ss’;
SET DateFormat=’DD.MM.YYYY’;
SET TimestampFormat=’DD.MM.YYYY h:mm:ss[.fff]’;
SET MonthNames=’янв;фев;мар;апр;май;июн;июл;авг;сен;окт;ноя;дек’;
SET DayNames=’Пн;Вт;Ср;Чт;Пт;Сб;Вс’;

Календарь:
load * Inline
[Дата, Квартал, Месяц, Год, День, Неделя, День недели];

Let ТекущаяДата = Num(Today(1));
Let ПрошедшийПериод = -10;
Let БудущийПериод = 0;

For i = $(ПрошедшийПериод) to $(БудущийПериод)
Concatenate(Календарь)
Load
Date ($(ТекущаяДата) + $(i)) as Дата,
‘Q’ & Ceil(Month($(ТекущаяДата) + $(i))/3) as Квартал,
Month (Date($(ТекущаяДата) + $(i))) as Месяц,
Year (Date($(ТекущаяДата) + $(i))) as Год,
Day (Date($(ТекущаяДата) + $(i))) as День,
week($(ТекущаяДата) + $(i)) as [Неделя],
weekday($(ТекущаяДата) + $(i)) as [День недели]
AutoGenerate 1
;
Next i;

Мероприятие:
Load * inline [
Дата старта мероприятия, Дата окончания мероприятия, Наименование мероприятия
01.01.2015, 05.01.2015, Мероприятие 1
01.01.2015, 03.01.2015, Мероприятие 2
02.01.2015, 06.01.2015, Мероприятие 3
02.01.2015, 04.01.2015, Мероприятие 4
03.01.2015, 03.01.2015, Мероприятие 5
03.01.2015, 05.01.2015, Мероприятие 6
04.01.2015, 05.01.2015, Мероприятие 7
05.01.2015, 10.01.2015, Мероприятие 8
06.01.2015, 11.01.2015, Мероприятие 9
];

A: Т.е. при выделении даты требуется отобрать записи мероприятий которые действуют на эту дату?
Обратите внимание на функцию IntervalMatch()
возьмите лет десять и сравните создание календарей на этот период в двух вариантах по времени и задействованным ресурсам.

Q: Привет, такой вопрос:

У меня есть поле в excel с таким содержанием:
Код:
http://www.сайт.ru/promo.html?utm_source=YD&utm_medium=cpc&utm_content=prodvizhenie&utm_campaign=obshhie_poisk_spb&yclid=5807162979809803946

Можно ли написать какой нить фильтр который выводил бы значения переменных из ссылки к примеру из utm_source=YD брал значение YD, и так далее по всем переменным в cсылке.

A: Конечно, как ни странно, но это тоже структурированная информация.
? — начало строки параметров
& — разделитель параметров
= — разделитель параметр/значение.
Думаю, для скрипта понадобится написание макроса.

Q: Доброго времени суток. Я только начинаю работать с qlikview и столкнулся с такой задачей которую не получается решить. Не подскажите как можно объединить повторяющиеся фразы в одну строку и сложить по ним расходы? (скриншот ниже).

A: Создайте объект диаграмма с измерением — Фраза и выражением для подсчета сумм
sum([Расход])
Тип диаграммы выбирается на вкладке «Общая» свойств диаграммы.
Выбираем иконку таблицы (нижний ряд, крайняя правая) Прямая таблица.

Q: Как обеспечить загрузку уникальных записей — аналог первичного ключа?

A: Если речь идет о загрузке уникальных значений поля из таблицы то следует использовать DISTINCT, например, код:
Код:
LOAD Distinct %ID INLINE [
%ID, A
0, 0
1, А
1, Б
1, В
2, Г
2, А
2, Б
3, В
3, Г
3, А
4, Б
4, В
4, Г
5, Д
5, Е
6, А
];
создаст таблицу :
%ID
1
2
3
4
5
6

Если идет речь о создании ключевого поля из комбинации полей, то в простых случаях можно использовать обычное сцепление текстовых значений, т.е. конструкция:
Код:
LOAD Distinct %ID&A as [%Key] INLINE

вернет уникальные записи типа 1А,1Б и т.д..

Также можно использовать одну из хэш-функций Qlikview: Hash128, Hash160, Hash256.
В этом случае мы также получим уникальный ключ для комбинации значений записи.
Код:
LOAD Distinct %ID&A as [%Key], Hash128(%ID,A) as %Key128, Hash160(%ID,A) as %Key160,Hash256(%ID,A) as %Key256 INLINE
Дает нам таблицу:
(Извините, но вы не имеете доступа к галерее)

Все вышесказанное справедливо и для Qlik SENSE,
ссылка на описание функций

Q: Хочу связать две таблицы. При этом хочу, чтобы из таблицы Клиенты (CUSTTABLE) выводились бы все значения вне зависимости от наличия для клиента плана (CUSTPLANCUSTOMERS). Пытаюсь сделать соединение, но лезут ошибки. Что делаю не так? Спасибо!

Код: [Выделить]
SQL SELECT КОД_КЛИЕНТА
FROM «MD_DynAXNewArc».dbo.CUSTTABLE;

SQL SELECT КОД_КЛИЕНТА,
AMOUNT as ‘СУММА ПЛАНА’,
TRANSDATE as ‘ДАТА’
FROM «MD_DynAXNewArc».dbo.CUSTPLANCUSTOMERS LEFT JOIN «MD_DynAXNewArc».dbo.CUSTTABLE ON «MD_DynAXNewArc».dbo.CUSTPLANCUSTOMERS.КОД_КЛИЕНТА= «MD_DynAXNewArc».dbo.CUSTTABLE.КОД_КЛИЕНТА;

A: Сталкивался как-то с тем, что отлаженный sql-запрос не работал через ODBC в Qlikview.
Но там было много условий и distinct.
В итоге просто взял нужные таблицы и обработал их уже средствами Клики.
Для начала, я бы проверил SQL — запрос не в Клике.

Q: Для дашборда нужно создать таблицу выбора месяцев.
При загрузке данных с access используется функция month([date]), все работает, только при таком решении месяца отображаются в числовом формате («6″,»7» и т.д)
Хотелось бы отображать в удобном текстовом («янв», «фев» и т.д.)
Когда на вкладке «Номер» выбираю «Дата» и MMM (вложение 114), в списке не происходит группировка и отображается множество записей «июнь»

Каким образом можно решить проблему?

A: Здесь есть пример по формированию календаря.
Если календарь не используется то придется календарные измерения формировать в таблице фактов.
На скриншоте показан скрипт загрузки данных из Access. Сразу бросается в глаза отсутствие операторов предварительной загрузки, load перед select.
В руководстве почитайте главы по загрузке данных.

Q: Помогите пожалуйста решить проблему:
В загружаемом из Excel столбце текст(точнее, цифры) разделены двоеточием. Необходимо, чтоб в модели этого разделителя-двоеточия не было. («11111:222» -> «11111222»). В исходном экселевском файле ничего менять нельзя. Как это сделать?

A: KeepChar(s1 , s2)
Возвращает строку s1 кроме символов, не содержащихся в строке s2.


Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
FAQ по скрипту Qlik Sense/Qlik View часть 6

Q: Всем доброго времени суток!

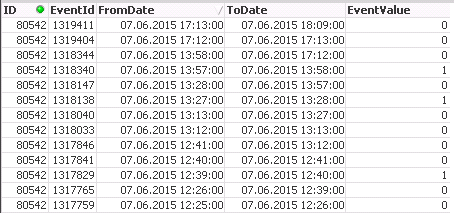
Имеется следующая таблица событий:
где ID -идентификатор оборудования, EventId — id события, FromDate — дата начала события, ToDate — дата окончания события, EventValue — состояние оборудования в данный промежуток времени (0 — OK, 1 — Problem).
Таблица отсортирована по ID, EventId (чем больше FromDate, тем больше EventId).

Задача состоит в том, чтобы удалить лишние записи: если несколько событий подряд идут с одним и тем же EventValue, то оставляем минимальный EventId и FromDate, а к нему добавляем максимальный ToDate. В итоге не должно быть одинаковых подряд идущих EventValue.
Фактически, верхние 3 записи из данной таблицы говорят о том, что оборудование находилось в состоянии 0 (ОК) с 07.06.2015 13:58:00 по 07.06.2015 18:09:00.

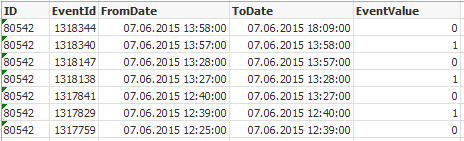
Например, из таблицы выше нужно получить следующую:
Все это нужно сделать в скрипте загрузок.

П.С. Скорее всего, записи надо как-то грамотно сгруппировать.

A:Надо добавить флаг на смену состояния.
Например, сменилось состояние сенсора — ставим уникальный номер либо EventId.
Затем по нему и группируем.
Код:
temp1:
LOAD * INLINE [
ID, EventID, FromDate, ToDate, EventValue, Flag
80542, 1317759, 07.06.2015 12:25:00, 07.06.2015 12:26:00, 0, 1317759
80542, 1317765, 07.06.2015 12:26:00, 07.06.2015 12:39:00, 0, 1317759
80542, 1317829, 07.06.2015 12:39:00, 07.06.2015 12:40:00, 1, 1317829
80542, 1317841, 07.06.2015 12:40:00, 07.06.2015 12:41:00, 0, 1317841
80542, 1317846, 07.06.2015 12:41:00, 07.06.2015 13:12:00, 0, 1317841
];

temp2:
NoConcatenate load ID,
min(EventID) as EventID,
min(FromDate) as FromDate,
max(ToDate) as ToDate,
Only(EventValue) as EventValue
Resident temp1

Q:Подскажите, каким образом вытащить текущую дату в Qlikview?

A: Можно вот так:
Код:
now()

или:
Код:
today()

Q: Есть следующая задачка:
необходимо контролировать сроки выполнения задач, при этом для более гибкого контроля в систему должен быть заложен сдвиг на 3 рабочих дня относительно планового срока.
Как посчитать разницы между датами в рабочих днях в справке описано, по своей задачке пока ничего не нашёл.

A: Возможно так подойдет: LastWorkDate (Data, 3).

Q: Подскажите как можно организовать загрузку обновленных данных. А именно имеется около 300 000 xml файлов число которых увеличивается ежедневно примерно на три пять тысяч. в каждом файле также примерно около 50 строк, перезагружать данные соответственно занимает очень много времени… привожу пример кода для удобства.
Код:
SET ThousandSep=’ ‘;
SET DecimalSep=’,’;
SET MoneyThousandSep=’ ‘;
SET MoneyDecimalSep=’,’;
SET MoneyFormat=’# ##0,00 ₽;-# ##0,00 ₽’;
SET TimeFormat=’h:mm:ss’;
SET DateFormat=’DD.MM.YYYY’;
SET TimestampFormat=’DD.MM.YYYY h:mm:ss[.fff]’;
SET MonthNames=’январь;февраль;март;апрель;май;июнь;июль;август;сентябрь;октябрь;ноябрь;декабрь’;
SET DayNames=’Пн;Вт;Ср;Чт;Пт;Сб;Вс’;

export:
Load
FileName() as [Имя файла],
[fcsNotificationEF/id] as id,
[fcsNotificationEF/purchaseNumber] as [№ закупки],
mid([fcsNotificationEF/docPublishDate],9,2) as [День публикации закупки],
Month(mid([fcsNotificationEF/docPublishDate],1,10)) as [Месяц публикации закупки],
mid([fcsNotificationEF/docPublishDate],1,4) as [Год публикации закупки],
mid([fcsNotificationEF/docPublishDate],9,2)& ‘ ‘ & Month (mid([fcsNotificationEF/docPublishDate],1,10))& ‘ ‘ &mid([fcsNotificationEF/docPublishDate],1,4) as [Дата публикации закупки],
ceil(Month(mid([fcsNotificationEF/docPublishDate],1,10))/3)&’ квартал’ as Квартал,
[fcsNotificationEF/href] as [Ссылка на ООС],
[fcsNotificationEF/purchaseObjectInfo] as [Предмет закупки],
[fcsNotificationEF/lot/maxPrice] as [НМЦК],
[fcsNotificationEF/lot/financeSource] as [Источник финансирования],
[fcsNotificationEF/lot/customerRequirements/customerRequirement/deliveryTerm] as [Сроки поставки товара],
[fcsNotificationEF/lot/customerRequirements/customerRequirement/applicationGuarantee/amount] as [Обеспечение заявки],
[fcsNotificationEF/lot/customerRequirements/customerRequirement/contractGuarantee/amount] as [Обеспечение контракта],
[fcsNotificationEF/lot/customerRequirements/customerRequirement/contractGuarantee/part] as [Процент на обеспечение исполнения контракта],
[fcsNotificationEF/lot/customerRequirements/customerRequirement/applicationGuarantee/part] as [Процент на обеспечение заявки],
[fcsNotificationEF/lot/customerRequirements/customerRequirement/kladrPlaces/kladrPlace/kladr/fullName]&’ ‘&[fcsNotificationEF/lot/customerRequirements/customerRequirement/kladrPlaces/kladrPlace/deliveryPlace] as [Место доставки товара, выполнения работ],
mid([fcsNotificationEF/procedureInfo/bidding/date],9,2)& ‘ ‘ & Month (mid([fcsNotificationEF/procedureInfo/bidding/date],1,10))& ‘ ‘ &mid([fcsNotificationEF/procedureInfo/bidding/date],1,4) as [Дата Аукциона/Определения победителя],
mid([fcsNotificationEF/procedureInfo/collecting/startDate],9,2)& ‘ ‘ & Month (mid([fcsNotificationEF/procedureInfo/collecting/startDate],1,10))& ‘ ‘ &mid([fcsNotificationEF/procedureInfo/collecting/startDate],1,4) as [Дата начала подачи документов],
[fcsNotificationEF/procedureInfo/collecting/place]&’ ‘&[fcsNotificationEF/ETP/name]&’ по адресу ‘&[fcsNotificationEF/ETP/url] as [Место подачи заявки],
[fcsNotificationEF/procedureInfo/collecting/order] as [Порядок подачи заявок],
mid([fcsNotificationEF/procedureInfo/collecting/endDate],9,2)& ‘ ‘ & Month (mid([fcsNotificationEF/procedureInfo/collecting/endDate],1,10))& ‘ ‘ &mid([fcsNotificationEF/procedureInfo/collecting/endDate],1,4) as [Дата окончания подачи документов],
[fcsNotificationEF/ETP/name] as [Площадка],
[fcsNotificationEF/ETP/url] as [Адрес площадки],
[fcsNotificationEF/placingWay/name] as [Тип закупки],
Replace([fcsNotificationEF/lot/purchaseObjects/purchaseObject/OKPD/code],’.’,’_’) as [ОКПД],
[fcsNotificationEF/lot/purchaseObjects/purchaseObject/OKPD/name] as [Наименование ОКПД],
[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactEMail] as [EMail заказчика],
[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactPhone] as [Телефон заказчика],
[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactFax] as [Факс заказчика],
[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactPerson/lastName] as [Фамилия ОЛ],
[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactPerson/firstName] as [Имя ОЛ],
[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactPerson/middleName] as [Отчество ЛО],
[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactPerson/lastName]&’ ‘&[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactPerson/firstName]&’ ‘&[fcsNotificationEF/purchaseResponsible/responsibleInfo/contactPerson/middleName] as [ФИО ответственного лица заказчика],
[fcsNotificationEF/purchaseResponsible/responsibleOrg/fullName] as [Заказчик],
[fcsNotificationEF/purchaseResponsible/responsibleOrg/postAddress] as [Почтовый адрес],
[fcsNotificationEF/purchaseResponsible/responsibleOrg/factAddress] as [Фактический адрес],
trim(subfield([fcsNotificationEF/purchaseResponsible/responsibleOrg/factAddress],’,’,3)) as [Область],
trim(subfield([fcsNotificationEF/purchaseResponsible/responsibleOrg/factAddress],’,’,4)) as [Город],
[fcsNotificationEF/purchaseResponsible/responsibleOrg/INN] as [ИНН заказчика],
[fcsNotificationEF/purchaseResponsible/responsibleOrg/KPP] as [КПП заказчика],
%Key_export_2C54E0F74D336CCA // Key for this table: export
FROM [C:\Users\padij_000\Desktop\123\fcsNotificationEA44*.xml] (XmlSimple, Table is [export]);
// End of [аукцион.xml] LOAD statements

Так и не понял как это сделать с помощью Инкрементальной загрузки.

и еще вопрос не могу понять как добавить в таблицу дополнительное поле которое берется не из исходных данных а добавляется самим qlikview.

A: для начала, ответ на второй вопрос.
Дополнительное поле формируется в операторе Load.
Например
Код:
temp1:
LOAD F1, F2, F1+F2 as F3 INLINE [
F1, F2
1, 2
4, 3
5, 6
3, 7
];
В исходной таблице только два поля F1 и F2, третье поле формируется в операторе load, в данном случае сумме двух полей F1,F2 назначено новое имя F3.

Q: Подскажите как можно в qlikview взять определенный текст из строки?
Нужно из адресов типа » Российская Федерация, 630007, Новосибирская обл, Новосибирск г, Колыванская, 104, — » взять только область в данном случае это «Новосибирская обл»

A: Как и в любом другом языке программирования в Qlikview & Sense присутствует целый набор функций для работы с текстовыми значениями.

Во вложении приведен вариант решения задачи (формула в нижней строке).
Описания функций можно найти по ссылке выше.
Если же адреса в этом поле имеют разные форматы, т.е. не последовательность «Страна, Индекс, Область, ..» а например — «Индекс, область,..», то придется проанализировать все варианты и прописывать условия на определение формата в котором записан адрес и соответствующее выражения для каждого случая.
В данном варианте мы:
вырезаем функций MID() из строки Adr,
начиная с позиции после второй запятой Index(Adr,’,’,2)+1,
подстроку между 2 и 3 запятыми Index(Adr,’,’,3)-Index(Adr,’,’,2)-1,
и результат дополнительно очищаем от крайних пробелов функцией TRIM()
Код:
trim(
mid(Adr,
Index(Adr,’,’,2)+1,
Index(Adr,’,’,3)-Index(Adr,’,’,2)-1
))

Q: Изначально имеется таблица событий: начало события, конец события …(№ оборудования — ключ, дата (дд.мм.гггг) — ключ).

К ней, с помощью left join сначала прицепляю одну таблицу по одному ключу, потом прицепляю еще 2 таблицы по двум другим (один появился только после предыдущей операции): по № и по дате (дд.мм.гггг).
Проблема в том, что если в изначальной таблице было несколько событий за Date для данного номера, то прицепляет он только одну запись:
Так то оно понятно, что так и должно быть. Но как можно эту проблему обойти?

На всякий случай код приложил.
Код:
Events:
LOAD hostid,
<...>,
Date(curtime) as Date
FROM [D:\QlickView\Data\Event.qvd] (qvd);

Left Join
LOAD hostid,
ATM,
<...>
FROM [D:\QlickView\Data\ATM_info.qvd] (qvd);

Left Join
LOAD
ATM,
Date,
TT_Created,
TT_Closed
Resident TT;
DROP Table TT;

Left Join
LOAD ATM,
Timestamp(NotEnabledFrom) as NotEnabledFrom,
Timestamp(NotEnabledTo) as NotEnabledTo,
Date(NotEnabledFrom) as Date
FROM [D:\QlickView\Data\NotEnabled.qvd] (qvd);
http://i024.radikal.ru/1504/64/40d2eddca2be.png
http://s017.radikal.ru/i437/1504/35/bb715dc4b652.png
A:
Не совсем уверен, что правильно понял проблему.
Вроде бы если в ТТ есть записи для ATM и Date , то TT_Created и TT_Closed должны быть заполнены значениями для одинаковых ATM и Date.
В качестве совета, попробуйте после каждого объединения выводить в промежуточный QVD, в целях отладки.
И дальнейшие связи делать уже с промежуточной таблицей,
т.е. примерно в такой последовательности.
1:
load
let join load
store into qvd
drop table 1;
load
left join
ну, и так далее.
Посмотрите результаты на каждом этапе, может что обнаружится неожиданное.

Q: Есть список где показывается 0 и 1, как их переименовать в списке, что бы показывалось. Да и Нет.

A: В списке есть возможность выбрать <выражение> вместо поля в самом низу.
И там уже написать что-то вроде : if(pole=1, ‘Да’, ‘Нет’)

Или, возможно, с точки зрения «красивости» и всякого прочего дизайна выгоднее создать 2 текстовых объекта «Да» / «Нет» и юзать всё многообразие настроек.
в них выбрать действие/выбор в поле/…

Q: Подскажите пожалуйста, почему не работает Order by?

Код:
// Загружаем данные
Товарные_запасы:
LOAD Товар,
Дата,
[Прогноз продаж],
[Товарные запасы]
FROM
[C:\Товарные_запасы.xlsx]
(ooxml, embedded labels, table is Лист3)
Order by Дата;

В таком же примере. где используется resident ____Таблица_____ Order by работает.
В чем может быть причина.

A: order by работает только с load resident.
Сначала грузим с файла, затем в памяти
noconcatenate
load
tra lalal

resident …
order by

Q: Уважаемы, подскажите пожалуйста, а как удалить Вкладки внутри скрипта?

A: В верхней панели:
Вкладка/удалить

Q: Как сделать перебор строк в таблице?

A: Перебор строк возможен, но не всегда это правильное решение, т.к. исполнение циклов занимает намного больше времени, чем SQL-запросы. Но встречаются ситуации, когда перебор является единственным разумным решением, например в теме про формирование переменных из таблицы
Код:
Variables:
LOAD * FROM
$(QVD_Path)Variables.qvd (qvd);

FOR i=0 to noofrows(‘Variables’)-1
LET var_name= peek(‘Variable_name’,i,’Variables’);
LET $(var_name) = peek(‘Variable_value’,i,’Variables’);
NEXT i
Использование переменных необходимо, т.к. мы не можем в Qlikview в рамках скрипта встать на какую-либо запись в загруженную таблицу,но мы можем обращаться к записям, по номеру строки и сохранять данные в переменные для дальнейшего использования.

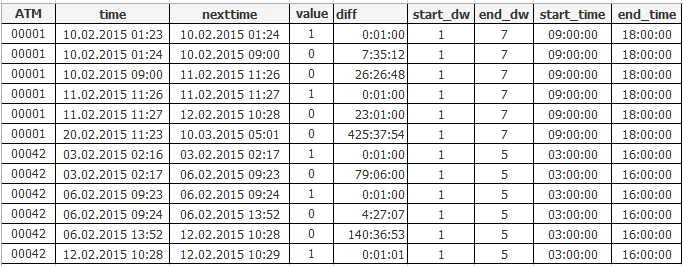
Q: Доброго времени суток!

Похожую задачу я уже как-то озвучивал на форуме. Сейчас условие немного другое.
Имеется таблица событий следующего типа
time — начало события,
nexttime — конец события
diff — интервал в формате hh:mm:ss
start_dw -первый день недели рабочего времени
end_dw — последний день рабочего времни
start_time — начало раб.времени
end_time — конец раб. времени

Нужно посчитать разницу между time и nexttime в рабочее время.
Когда time и nexttime — один день, это легко, а вот если это разные дни? У меня даже идей нет…

A: Только сейчас кстати заметил, что раб день не нормирован.
Тогда меняем
networkdays(Time,NextTime)/3
на
networkdays(Time,NextTime)* (end_time-start_time)

Q: Каким образом загружать в скрипте только новую таблицу?

A: Модель данных формируется в процессе выполнения скрипта, связи строятся на последнем этапе после загрузки всех таблиц и добавить новую таблицу в уже существующую модель без повторного запуска скрипта невозможно.
Или вопрос касается загрузки измененных данных из источника, без повторной загрузки всех записей?

Q: Добрый день, ни как не могу стандартными средствами решить следующую задачку.
В сводную таблицу выводятся следующие данные, других просто нет. Получающийся результат на скриншоте ниже.

А мне нужно, чтобы получалось так.

Т.е. даты с 01.01.2015 по 11.01.2015 ставятся автоматически(так как между ними нет даты со значением),а вот значение во всех датах ставятся из даты 01.01.2015.

Копаю в сторону intervalmatch() но пока ни как не могу применить, что бы получился такой же результат.

Бужу благодарен любому совету, так как уже голову сломал.

A:Интервал тут не при чем.
Вам необходимо сформировать записи на даты между имеющимися значениями.
Смотрите по аналогии применение peek() в формировании записей на выходные дни для курсов валют


Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
FAQ по скрипту Qlik Sense/Qlik View часть 5

Q: Каким образом исключить целую строку на уровне скрипта.
К примеру:
Код:
Таблица 1:
1, test, Иванов
2, info, Петров
3, info, Соколов

На уровне скрипта исключаем, все записи с test.

В итоге получаем таблицу:
Код:
2, info, Петров
3, info, Соколов

Как это сделать?

A: LOAD *
FROM Таблица 1
Where Field2 <> ‘test’;

Q: Слышал, про такую удивительную вещь, что можно создать ключ по последним символам. Приведу пример:
Код:
Таблица 1:
+7 911 655 75 29, Иванов
+7 911 655 75 30, Петров
+7 911 655 75 31, Федоров
+7 911 655 75 32, Кузнецов

Код:
Таблица 2:
911 655 75 29, Москва
911 655 75 30, Воронеж
911 655 75 31, Мурманск
911 655 75 32, Москва

В итоге после формирования ключа и джойна, получаем следующую таблицу:

Код:
Таблица 3:
911 655 75 29, Москва, Иванов
911 655 75 30, Воронеж, Петров
911 655 75 31, Мурманск, Федоров
911 655 75 32, Москва, Кузнецов

A: таблица1:
load Right(НомерПлюс,13) as Номер,ФИО ;
LOAD * INLINE [
НомерПлюс, ФИО
+7 911 655 75 29, Иванов
+7 911 655 75 30, Петров
+7 911 655 75 31, Федоров
+7 911 655 75 32, Кузнецов
];

таблица2:
LOAD * INLINE [
Номер, Город
911 655 75 29, Москва
911 655 75 30, Воронеж
911 655 75 31, Мурманск
911 655 75 32, Москва
];
Без джойнов, ключ по 13 правым символам.

Q: Есть таблица, Область — Регион — Регион РФ
Нужно, записать данные из столба Регион РФ поверх данных Регион. И оставить один объеденный столбец Регион.
Стоит добавить, что «Регион» и «Регион РФ» образуются в результате left join двух таблиц. Если сразу join`ить в Столбец «Регион», то данные по чему то не записываются.
join`ил следующим образом:
Код:
// Присоеденяем Регионы СНГ и МИР (МиМо, РФ, СНГ, Мир)
LEFT join (Demo_N)
LOAD
Страна,
Регион
FROM [lib://Demo_Country.xlsx]
(ooxml, embedded labels, table is Лист1);

// Присоеденяем Регионы МиМо и РФ (МиМо, РФ, СНГ, Мир)
LEFT join (Demo_N)
LOAD
Страна,
Область,
Регион as Регион_РФ
FROM [lib://Demo_Regions.xlsx]
(ooxml, embedded labels, table is Лист1);
http://i.imgur.com/TLYweZC.png
A:
Так же можно if-ом поиграться)
Код:
Tmp:
load * inline [
Область, Регион, РегионРФ
Краснодарский край, РФ, РФ
,СНГ,
Москва,РФ,МиМо
,Мир,
];

Add NoConcatenate
FactTable:
load Область,
Регион,
РегионРФ,
if(IsNull(РегионРФ) or len(РегионРФ)=0, Регион, РегионРФ) as НовыйРегион
Resident Tmp;

drop table Tmp;

Q: суть проблемы в следующем
есть 2 даты надо подсчитать кол- во дней межу этими датами которые были рабочими, т.е. исключить кол- во выходных и праздничных дней

A: описание функции networkdays
Если используются «хитрые графики», то можно привязать график к календарю, проставив единички в колонке рабочих дней и затем просто подсчитать сумму с выражением Set Analysis.

Q: Знатоки, подскажите, пожалуйста, можно ли использовать AGGR функцию в скрипте?

Пример, пытаюсь на основе загруженных данных сделать расчет в скрипте и загрузить его дополнительным полем. Но начиная с sum функции перестают подсвечиваться, как бывает, когда ошибка в коде….

LOAD
[№ заказа],
aggr(sum([Кол-во в заказе на дату заказа, шт.]),[№ заказа]) as [Кол-во позиций в заказе на дату заказа]
RESIDENT Таблица1;

A: Нет,
аналогичный aggr-у результат может быть получен конструкцией:
Код:
load sum([Кол-во в заказе на дату заказа, шт.]) As [Сумма в заказе]
resident откуда-то
GROUP BY [№ заказа]

Q: Имеется, вот такая таблица.

Нужно посчитать таким образом, что бы вместо пустой ячейки выводился текст.

К примеру в итоге должно получиться следующее:
200 — Иванов
100 — Петров
100 — Не учтено.
Итого: 400

A: Самый простой способ прописать в формуле:
— в измерениях:
Код:
if(isnull(Продажа), ‘Не учтено’, Продажа)
— в скрипте в вашей Таблице фактов:
Код:
if(isnull(Продажа), ‘Не учтено’, Продажа) as Продажа
Вам решать, какой вариант лучше 🙂

Q: Подскажите, пожалуйста, по следующему вопросу. Загружаю 2 таблицы.
Первая содержит 3 поля:
— название товара,
— дата покупки,
— количество.
Вторая таблица содержит 2 поля:
— название товара,
— цена товара.

Мне нужно создать оповещение — если после загрузки скрипта есть товары, у которых поле «Цена товара» получается пустое, то нужно вывести такие товары в сообщении или в отдельной таблице, если это возможно. Подскажите, пожалуйста, как это реализовать?

A: Можно вывести значения в список.

1. Создаем новый объект листа — «Список»
2. В выборе поля — «<Выражение>»
3. Прописываем:
Код:
if(ЦенаТовара = 0 or isnull(ЦенаТовара), НазваниеТовара)

В этом случае у нас будут отображаться товары, у которых «Цена товара» пустое.

Чтобы не висел список постоянно, а появлялся только при обнаружении таких случаев, ставим условие на видимость объекта.
В свойствах списка — Макет -> Показать -> По условию:

Код:
count(if(ЦенаТовара = 0 or isnull(ЦенаТовара), НазваниеТовара))>0

P.s.: Так же можно прописать все в скрипте:

Код:
ТаблицаЦен:
load * inline [
НазваниеТовара, ЦенаТовара
1,100
2,200
3,300
4,
]
;

НулевыеЦены:
load if(ЦенаТовара = 0 or isnull(ЦенаТовара), НазваниеТовара) as НазваниеТовараСНулевойЦеной
resident ТаблицаЦен
;

У нас теперь есть отдельное поле, которые выводим в список.
Получаем список с одним значение «4»

Q: Привет, если я правильно понял задачу то вот примерный код:
Код:
export:
LOAD
FileName() as [Файл контракта],
[contract/id] as id,
[contract/number] as [№ контракта],
[contract/regNum] as [Номер реестровой записи контракта],
[contract/priceInfo/price] as [Цена контракта],
[contract/href] as [Ссылка на источник],
Date(Left([contract/publishDate],10),’DD MMMM YYYY’) as [Дата публикации]
FROM [Контракты\contract_*.xml] (XmlSimple, Table is [export]);
STORE * from export into export0.qvd (qvd);
DROP Table export;

tmp0:
Load *, Hash160([Номер реестровой записи контракта],[Дата публикации]) as IdRow from export0.qvd (qvd);
STORE * from tmp0 into export0.qvd (qvd);

tmp1:
load Hash160([Номер реестровой записи контракта],[МаксДата]) as IdRow;
LOAD max([Дата публикации]) as МаксДата,
[Номер реестровой записи контракта]
Resident tmp0
Group by [Номер реестровой записи контракта];
DROP Table tmp0;
Left join LOAD * from export0.qvd (qvd);
drop Field IdRow;

Но возникает вопрос, какую брать запись в том случае когда записи отличаются только по id? Как с
Номером реестровой записи контракта = 0151200007014000002 от 24/06/2015 .
Добрый день!
Номер id всегда уникален. А вот номер реестровой записи повторяется при внесение каких либо изменений в контракт. Соответственно нужно из нескольких записей с одинаковым реестровым номером взять данные с последней датой публикации.
Сейчас попробую данный код применить. Предыдущий код от KVV так и не смог приладить.

A: Обрати внимание на записи в снимке.
Все поля кроме ID и файла совпадают.

Q: Подскажите как данные
столбец столбец2 в нём суммы
«102000000
ВСеГО
I. СНг
АЗЕРБАЙДЖАН
II. Государства Мира
еВРОПА
НиДЕРЛАНДы
ПОЛЬшА
ФРАНЦиЯ
ЧЕХиЯ
«103000000
ПОЛЬшА
ФРАНЦиЯ
ЧЕХиЯ
загрузить так что бы можно было выбрать государство и сумму соответствующие определенному номеру

A:
Используя трансформацию мастера создания файлов можно прийти к требуемому результату за один этап загрузки.
Вот код, который формирует из моего примера требуемую таблицу.
Код:
LOAD text(@1) as Страна,
@2 As Значение,
text(@3) as Код
FROM [Книга1.xlsx]
(ooxml, no labels, table is Лист1, filters(
Remove(Row, RowCnd(CellValue, 1, StrCnd(equal, ‘Итого’))),
Remove(Row, RowCnd(CellValue, 1, StrCnd(contain, ‘Группа’))),
ColXtr(1, RowCnd(CellValue, 1, StrCnd(start, ‘1’)), 0),
Replace(3, top, StrCnd(null)),
ColXtr(1, RowCnd(CellValue, 1, StrCnd(start, ‘1’)), 0),
Replace(3, top, StrCnd(null)),
Remove(Row, RowCnd(CellValue, 1, StrCnd(start, ‘1’)))
));

Q: Осуществляю загрузку данных в свое приложение QlikView через Excel файлы.
Планирую ежемесячно обновлять данные и встал вопрос, а как QlikView обрабатывает полностью одинаковые строки (или дубликаты)?

По одной из таблиц моей модели происходит автоматическое связывание (я пополняю ее новыми данными). И иногда в пополняемых данных могут присутствовать уже строки, которые были ранее. Как их видит и обрабатывает QlikView?

Пример — на картинке строчка (дубликат во 2ой таблице) выделена желтым.

A: Проверьте
Код:

LOAD * INLINE [
F1, F2, F3
1, Кофта, 42
2, Штаны, 44
3, Блузка, 44
4, Футболка, 42
];

LOAD * INLINE [
F1, F2, F3
1, Кофта, 42
7, Футболка, 42
];
Будет загружено 6 записей в одну таблицу, «1, Кофта, 42» , будет повторяться.
В простой таблице будет отображаться 5 записей.
Наличие хоть одного Distinct приведет к тому, что дубли будут исключены. Но выглядит как-от непонятно, и чтобы не надеяться на внутренние механизмы Qlikivew можно сделать так:
Код:
load Distinct *;
LOAD * INLINE [
F1, F2, F3
1, Кофта, 42
2, Штаны, 44
3, Блузка, 44
4, Футболка, 42
];
LOAD * INLINE [
F1, F2, F3
1, Кофта, 42
7, Футболка, 42
];
В этом случае всем понятно что мы хотим сделать.

Q: Как реализовать подобную, штуку.
Нужно из xls файла залить данные по следующему принципу.
Столбец А, B, C с 15 по 31 строчку.
Столбец D, F, c 20 по 25 строчку,
Столбец М, только 22 строчку.

Обычно в загружал, только целый столбец, со всеми строчками. Как ограничить?

A: Попробуйте сделать три загрузки с уникальным ключом для последующего объединения.
На каждой загрузке прописываем условия, например:

Where RecNo()>14 and RecNo()<32; и т.д. Затем соединяем. Или вариант попроще, Просто прописываем условия в полях например If(recno()=22,Мин) as Мин, If(RecNo()>14 and RecNo()<32,Макс) as Макс,
Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
FAQ по скрипту Qlik Sense/Qlik View часть 4

Q: Подскажите пожалуйста как можно преобразовать текущий вид даты 6 мая 2015 в текстовом формате в такой вид 06.05.2015.

A: Что мы имеем? Имеем тестовую строку.
Нам надо ее разобрать на три составляющие.
Для расчленения используйте SubField(), в качестве разделителя — пробел, при это крайние пробелы надо предварительно убрать.
Для формирования формата даты — MakeDate()
Для перевода текстового обозначения месяца в числовое используйте маппинг.
ApplyMap() можно использовать в качестве параметра для MakeDate().

Q: Нахожусь в стадии изучения документации QlikView, но поставленную задачу (вероятно, весьма лёгкую для опытного человека) необходимо выполнить быстрее (а именно сегодня), чем я осилю документацию.
Не уверен, что правильно подобрал заголовок темы. Возможно, есть соврешенно иной подход.

Исходные данные:
Group Value
A 100
A 200
B 330
B 404
B 555
C 600
Я хочу подсчитать количество (не сумму) записей для каждой группы с учётом текущей выборки. Например, диаграмма «Прямая таблица» даёт нужный результат:
Group Count(Value)
A 2
B 3
C 1
Теперь я хочу получить строку вида «A=2,B=4,C=1», чтобы использовать, например, в текстовом объекте. Как это сделать? Прошу подсказать

A: Почитайте про функции: aggr(), concat(), rank, FirstSortedValue(), анализ множеств тоже не помешает.

Q: Есть поле LinkKey2. В этом поле есть данные номенклатурной группы и типов.Каким образом можно,с помощью AutoNumber,извлечь эти поля?Скорее все поле — autonumber(linkkey2) as linkkey2 — написано с ошибкой.

A: Не совсем понятна задача.
Что значит извлечь поля?
Почитайте про функции счетчика
Может autonumberhash128() более подходящая в этом случае функция?

Q: Подскажите,пожалуйста, есть ли такая функция в клике,которая проверяет строчку и если в ней содержаться буквы, то выводит определенное значение, а если нет,то null. Нужно отсортировать строчки где есть только цифры от строчек где содержаться еще и буквы.

A: Вариантов масса, например
if(
len(keepchar ( Field,’0123456789′ ))= len(Field) , значение, null())

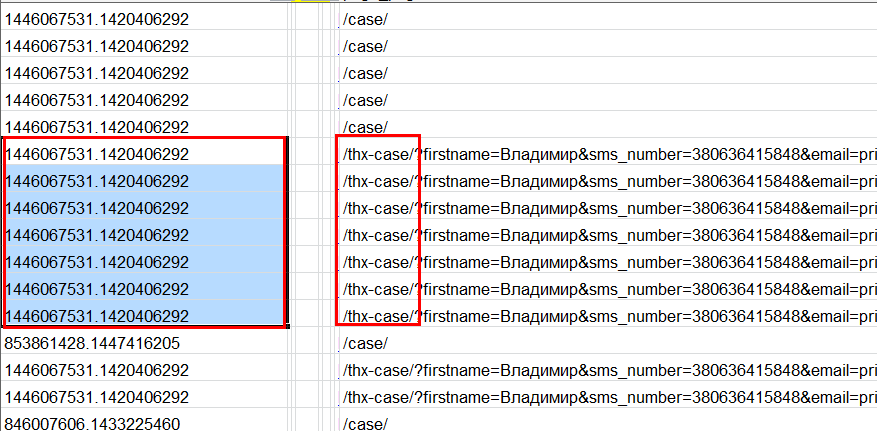
Q: Не подскажите как лучше такое реализовать. Есть таблица с заявками с двумя полями id и page. Некоторые заявки дублируются из за особенности работы системы сбора аналитики. Как можно подсчитать уникальное количество id у которого в поле pageприсутствует слово thx-case , слово thx-case и обозначает что это оформленная заявка и одинаковые надо склеить и подсчитать.

A: load distinct * оставит только уникальные значения.

Q: Есть исходное приложение. Из этого приложения необходимо выгрузить определенные справочники в эксель файл и обезличить их (к примеру холодильник-товар1,телевизор-товар2,Иркутск-Филиал1 и т.д.).После обезличивания данных,необходимо их снова загрузить в исходное приложение.Проблема в том,что когда заношу обезличенные данные в скрипт,а потом нажимаю «Загрузить»,то загрузка происходит с ошибками,т.к. той бд,что в приложении у нас нет.
Вопрос:возможно, есть какие-либо другие способы занести обезличенные данные в скрипт и успешно обновить?

A: Иногда приходиться такое делать.
В основном использую функцию RowNo() в загрузке данных.
Также, иногда нужно исказить и числа, потому можно умножить/поделить и т.д., например, на 1,15 или использовать функцию Rand().

Маленький пример:
Код: [Выделить]
Clients:
LOAD CLIENT_ID,
‘Shop_’ & num(RowNo(), 000) as CLIENT_NAME
From Dict_Clients.qvd (qvd);

Q: Очень нужна ваша помощь.
Есть таблица с данными в виде среза,т.е в таком виде.
Дата, Сотрудник, Вид выплаты, сумма
01.01.15, Иванов, оклад,10000
01.01.15, Иванов, премия,5000
03.03.15, Иванов,премия,1000
05.05.15, Иванов,оклад,15000
Из таблицы такого типа мне нужен оклад сотрудника на каждый месяц, но запись есть лишь тогда,когда оклад либо назначается при приеме на работу,либо при изменении этого оклада,к примеру если человеку его повысили. Как можно решить такого типа проблему? Нужен оклад на каждый месяц.

A: посмотрите примеры использования функции peek(), например в теме по загрузке курсов валют peek() используется для заполнения недостающих записей котировок на выходные дни.
В вашем случае потребуется привязать таблицу к календарю, отсортировать по сотруднику и периоду и заполнить недостающие сведения из предыдущей записи.

Q: Задача звучит просто, но как сделать пока не могу найти.

Задача:
Есть задания (tasks), есть логи изменения их состояний (task_logs)
Выглядит это допустим так:
Мы видим, что task1 (task_id=1) был ‘создан'(created), ‘назначен'(assigned) и ‘взят в работу'(active) в неделю под номером W43.
А task2 был создан и назначен в W42, в W43 с ним ничего не происходило, поэтому нет ни одной записи за эту неделю о изменении его статуса, а в W44 он был решен и закрыт.

Мне же необходимо построить chart с грануляцией по неделям с информацией сколько же в каждую неделю было незакрытых task-ов(т.е. все задания в статусах не равных ‘закрыт’). За W43 у меня есть записи в логах только по одному task-у, но ‘незакрытых’ task-ов должно посчитаться 2, а не 1.

Каким образом можно это сделать? в оракле я б использовала аналитические функции, а тут мне не хватает знаний.

Огромное спасибо за помощь! очень жду ваших советов

A: Первое,что приходит в голову
Сначала перестроить таблицу, так чтобы появилось 2 столбца: BEGIN_wk END_wk:
Примерно так:

Код:
tmp:
LOAD *,
if(id_task=Previous(id_task) , Previous(week), weekname(‘01.01.2100′) ) as END_wk, weekname(log_updated_at) as BEGIN_wk
from task_logs where status=’created’ or status=’closed’
Order by id_task, log_updated_at desc;

interval_table:
load * resident tmp where status=’created’;

drop table tmp;

Затем можно это дело привязать к календарю через
Код:
Intervalmatch (WEEK_FROM_CALENDAR) load BEGIN_WK ,END_WK resident tmp;
Ну и дальше считать через count distinct

Q: Дана таблица. Как можно получить значения соответствующих месяцу коэфф. предыдущего года вместо нулей?

Т.е. в результате вместо нулей должны быть:
may-2015: 1,56 6
jun-2015: 1,658
jul-2015: 0,829

P.s. т.е. тем месяц-годам с конца, у которых отсутствовали продажи взять соотв. коэфф. из предыдущего года.

A: if(Sales=0,peek( ‘Коэф’, -12 ),’Коэф’)
Вроде бы так, если с синтаксисом не напутал, нет доступа к qv в ближайшие часы.

Q: на уровне скрипта нужно исключить все данные где есть слово «тест» в определенном столбце. Слово тест может стоять в начале текста, в конце, в середине. Как правильно сформировать условие?

Код:
WHERE [E] <> ‘Что тут должно сточть?’

A: Код:
where not WildMatch(…)

тестовый скрипт
Код:
test:
LOAD rowno() as %ID, * INLINE [
F1
Это тест
тест это
это тест наверняка
норма
правильная запись
];

NoConcatenate load * resident test where not WildMatch(F1,’*тест*’);
drop Table test;

Q: А чем проблема со временем?
Вам надо брать период с 00:00:00 по 23:59:59

Возьмем период с первого по 14 число октября.
Используя today() мы тем самым стираем время и получаем просто дату 01.10.2015 и т.д.
Так 01.10.2015 — это весь день, т.е. берутся данные с 01.10.2015 00:00:00 по 23:59:59. Конечный дата 14.10.2015. Тут аналогично — данные за весь деть. Тем самым мы получаем данные с 01.10.2015 00:00:00 по 14.10.2015 23:59:59.

Т.е. 01.10.2015 00:00:00 <=DATE_DOC <= 14.10.2015 23:59:59 Т.е. DATE_START <=DATE_DOC <= DATE_END . Но...у меня не работает today(), если подавать его на вход в SQL-запрос. Если прописать today() как переменные через LET, а потом добавить в него их - то же самое, ошибки, несоответствие формата. A: а попробуйте еще вот так:
Код:
let v_TodayMinus10 = Date(today() — 10) & ‘ 00:00:00’;

P.s. Скорее всего, действительно, перестали «глубоко вникать» в данный вопрос, так как решение казалось простым… Но на самом деле, может быть по другому.

Q: подскажите как можно высчитать оставшееся время до определенной даты в формате hh:mm:ss?
Допустим оставшееся количество до Нового года.

A: Смотри информацию по interval()

Код:
=interval(YearEnd(today())-today(),’ hh:mm:ss’)

Q: Подскажите как сделать связывание полей в QV11: одно поле содержит покупателей, где записаны их номера примерно в виде 01534211, где первые два символа (01 в данном примере) означают их регион. Также есть поле с этими самыми регионами. В задании присутствует множество покупателей в каждом регионе. Можно ли это сделать как то через скрипт?

A: Не совсем понятно, что нужно получить на «выходе».
Догадываюсь, что хотите разделить регион и покупателей.
Выделить регион в поле: left(Field_01, 2) as Region.
Выделить покупателей в поле: right(Field_01, 6) as Customer.

Будет хорошо, если опишете задачу более детально.
Можно ли это сделать как то через скрипт?
Конечно, ДА.
Как коллега правильно отметил, пример данных помог бы оперативно опубликовать решение по вашей задаче.

Q: Предположим, что у нас есть таблица, которая генерируется скриптом:
Код:
ExampleTbl:
LOAD * Inline [
field1, field2, field3
1,2,3
];

Как, к примеру, обновить field2? Может быть есть какая-то полезная фича? Не смог найти в открытых источниках =(

Обновить поле нужно именно в этой таблице. Возможно есть нестандартный прием? Или опять воротить через JOIN?

A: если такая необходимость возникает можно перезагрузить таблицу в скрипте с обработкой полей по нужному алгоритму и удалением оригинала. В результате останется таблица с измененными полями. Join и не нужен.

Q: Подскажите, пожалуйста, есть ли в скрипте альтернативная функция как ВПР в экселе?
То есть можно ли как-то сравнивать 2 разных текстовых поля в двух разных таблицах?
И если нашлись одинаковые значения, то нужно их вывести.

A: ВПР на английском VLOOKUP (это в Excel). Для QlikView существует аналог:
lookup(‘<Поле, которое показываем>‘,’<Поле в сравниваемой таблице, которое сопадает>‘,<Поле в исходной таблице>,’<Сравниваемая таблица>‘)

Пример:
Код:
Товары:
LOAD * INLINE [
ID Товара, Наименование товара, Цена товара
100, Удочка, 5000
101, Леска, 560
102, Крючок, 40
103, Пассатижи, 90
104, Складной нож, 2500
105, Рюкзак, 3000
106, Поплавок, 150
107, Наживка, 100
108, Кепка, 690
109, Жилет, 1800
110, Резиновая лодка, 7900
111, Фонарь, 2000
];

Транзакции:
LOAD * INLINE [
Номер транзакции, Код товара, Количество
1, 106, 2
2, 107, 1
3, 111, 1
4, 102, 1
5, 102, 1
6, 109, 1
7, 100, 2
8, 103, 1
9, 107, 1
10, 103, 1
11, 100, 1
12, 100, 2
13, 107, 1
14, 110, 2
15, 102, 1
16, 103, 1
17, 109, 1
18, 109, 1
19, 110, 1
20, 103, 1
21, 111, 1
22, 109, 1
23, 108, 1
24, 100, 2
25, 108, 1
26, 101, 1
27, 106, 1
28, 101, 2
29, 105, 1
30, 101, 1
];

[Сумма покупок]:
LOAD [Номер транзакции],
[Код товара],
[Количество],
lookup(‘Наименование товара’,’ID Товара’,[Код товара],’Товары’) as [Наименование товара],
lookup(‘Цена товара’,’ID Товара’,[Код товара],’Товары’) as [Цена товара],
[Количество]*lookup(‘Цена товара’,’ID Товара’,[Код товара],’Товары’) as [Сумма транзакции]
Resident [Транзакции];

DROP Tables [Товары], [Транзакции];

Q: Есть таблиц:
Товар Сумма товара Общая сумма всех товаров Процент от общей суммы
Яйца 25 55 25/55 = 0,45
Кефир 15 55 15/55 = 0,27
Молоко 10 55 10/55 = 0,18
Хлеб 5 55 5/55 = 0,09

Вопрос. Как посчитать накопительную сумму В СКРИПТЕ?
Чтобы получилась таблица вида:
Товар Сумма товара Общая сумма всех товаров Процент от общей суммы Накопительная сумма
Яйца 25 55 25/55 = 0,45 0,45
Кефир 15 55 15/55 = 0,27 0,72
Молоко 10 55 10/55 = 0,18 0,9
Хлеб 5 55 5/55 = 0,09 0,99

Это нужно, чтобы «посчитать» ABC-анализ.
Данную задачу можно решить через Expression, например, вот так — http://www.qlik4life.com/accumulation-in-qlikview/.
Но, более правильнее, рассчитать это в скрипте, так как данных достаточно много да и вообще, так будет правильнее.

A: Думаю, расчет накопительных сумм в таблице выражением будет удобнее

Q: опять возник вопрос по редактированию скрипта загрузки:

В таблице, есть поле дата, которое выглядит так: 2015-08-14 11:50:00
Как на уровне скрипта, привести к виду: 14.08.2015

A:
1.Код:
Date(2015-08-14 11:50:00, ‘DD.MM.YYYY’)

2.
Делаем фильтр вида:
Код:
Month(2015-08-14 11:50:00)
Будут показываться только месяцы


Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
FAQ по скрипту Qlik Sense/Qlik View часть 3

Q: Ребят подскажите, при перезагрузки скрипта бывает попадают файлы которые были ранее уже загружены и данные из них сохранены в qvd соответственно происходит дублирование значений. Как можно исключить добавления данных из ранее обработанных файлов? имена файлов уникальны.

A:Так то, distinct исключает дубли, но я бы рекомендовал сравнение по уникальному ключу через exist() при загрузке.

Q: Нужно получить время создания определенного файла qvd.

Код:
let vFileName=’C:\ProgramData\QlikTech\Documents\ЗаказПокупателейРХ.qvd’;

ДатаФайловЗагрузки:
load
FILETIME (‘$(vFileName)’) as ОбновлениеРХ;

При загрузке – ничего не происходит. Файл ЗаказПокупателейРХ.qvd есть

A: Filetime с параметром следует использовать для присвоения значения переменной, например:

Код:
let vTest=filetime(‘c:\test\test.7z’);

Без параметра функция используется для получения времени табличного файла, загружаемого в текущем Load. В этом случае значение будет в поле таблицы, для каждой записи.

Q: я голову сломал, форум прошерстил, не могу понять, как сделать простую вещь:
abon:
Load * Inline
[

Абонент, Подключился, Отключился

1, 01.01.2010, 01.02.2010
2, 01.01.2010, 01.03.2010
3, 01.01.2010, 01.03.2010
4, 01.02.2010, 01.03.2010
5, 01.02.2010, 01.04.2010
6, 01.02.2010, 01.05.2010
7, 01.02.2010,
8, 01.03.2010, 01.04.2010
9, 01.03.2010, 01.04.2010
10, 01.03.2010, 01.05.2010
11, 01.03.2010, 01.05.2010
12, 01.03.2010,
13, 01.04.2010,
14, 01.05.2010,
];

То есть у нас абоненты подключаются и отключаются, некоторые еще не отключились. Я могу вывести таблицу подключений и таблицу отключений, но как сделать таблицу общего притока/оттока по датам? То есть мне нужен приток-отток на дату.
Так как даты в разных колонках, общую агрегацию не сделать и даже, если использовать прегенерированный календарь, то все равно надо связать его с одной из двух колонок.

A: Посмотрите в хелпе информацию по intervalmatch().

Q: Имею таблицу базы данных, состоящую. например, из 2 столбцов:
1. Наименование
2. Статус.
Статус может принимать значение «актуальная» и «аннулирована».
Как загрузить только записи, имеющие статус «актуальная»?

пробовала в операторе Load использовать конструкцию Where Статус=’актуальная’, не работает….

A: в вашем случае
where wildmatch( [Статус], ‘актуальная’)

Q: Анализирую БД моей системы Service Desk и есть необходимость подсчитать время жизни заявки в днях-часах-минутах. Все вроде хорошо считалось через
interval(конечная дата — начальная дата)
но внезапно обнаружил, что если заявка переходит через год то ее возраст вместо 23 дней становится более 350.
Есть идеи как подсчитать возраст заявки чтобы результат получатся в формате DD hh:mm:ss ?

A: Вроде нормально все считает.
Код:
Interval(F2-F1, ‘DD hh:mm:ss’ )

Q: Опять нужен Ваш совет:
Есть таблица сохраненная в QVD файл, формируется с помощью инкрементальной загрузки, на каждый месяц, далее все это загружается в рабочую таблицу (данных очень много >1000000 обработанных файлов) необходимо удалять некорректные данные по списку допустим по полю «№» без перезагрузке всех данных.
в идеале создать таблицу xls и из нее взять нужные номера и удалить эти данные.

A: Можно создать таблицу с требуемыми исключениями и при загрузке проверять на существование exists() в ней.

Q: Задался другим интересным вопросом. А можно ли аддитивно складывать данные в один файл QVD? Есть ли аналог операции INSERT INTO в QlikView? Может есть параметр, который позволяет добавлять строчки в уже существующий файл QVD?

A: Ну как бы это не проблема, смотрим про инкрементальную загрузку.
Все через память, но это даже удобно становится.
таблица:
Load таблица1
concatenate Load ТакаяЖеКакТаблица1
store * from таблица into таблица1

Я наоборот, разделяю свои данные по годам.

Q: Возникла такая задача необходимо связать 2 таблицы по номеру телефона.
1 таблице тяну информацию по контакту из второй тяну информацию по продажам. Единственная возможность сделать связь только по номеру телефона (номера по клиентам точно соответствую как в заявке и в таблице продаж и не могут быть разными), но есть проблема с форматом ввода номера, 🙂 каждый записывает его кто как хочет и в разных таблицах он записан по разному, и получается нечто такое:

Phone
+75555555555
+7-555-555-55-55
7-555-555-55-55
85555555555
и т.д.

Как лучше сделать выборку данных по номерам привести их к одному виду и связать их между собой ключем (как вариант по последним 7 символам)?

A: Самое простое из приведенного вами списка
right ( replace(поле_номера_телефона,’-‘,») , 7 ) as НомерТелефона

Q: Только начинаю осваивать QLIKVIEW столкнулся с такой проблемой. Загружаю данные в QV из файла EXCEL. В одной колонке данные вида nms:1/2/3. Информативно для меня только первое числовое значение перед /, т.е. 1 в приведенном примере. Как заставить QV загружать только эти данные из конкретной колонки?

A: Если указанный формат значения справедлив для всех записей, то можно использовать функцию
TextBetween(s , beforetext , aftertext [, n ])
примерно так:
Код:
TextBetWeen(Поле,’nms:’,’/’)

Q: Я новичек. Изучаю Qlik Sense.
Искала ответ на свой вопрос в руководствах по Qlik, но либо не все понимаю, либо это невозможно сделать.
Прошу помочь, кто знает.
Задача такая:
Есть загруженные базы
Продаж
Orders:
LOAD
ID_Order,
ID_Sellers,
[Date],
ID_Product,
Product_count,
Product_sum
FROM ……….( table is Orders);
ID_Order ID_Sellers Date ID_Product Product_count Product_sum
1884 CB0000006 13.02.16 CB000000131 1.00 140 000,00
1884 CB0000006 13.02.16 CB000000332 1.00 220 000,00
1876 CB0000006 13.02.16 CB000000639 1.00 110 000,00
1876 CB0000006 13.02.16 CB000000640 1.00 110 000,00
1876 CB0000006 13.02.16 CB000002362 1.00 110 000,00
1876 CB0000006 13.02.16 CB000002365 1.00 110 000,00
1876 CB0000006 13.02.16 CB000002366 1.00 110 000,00
1876 CB0000006 13.02.16 CB000002368 1.00 110 000,00
1876 CB0000006 13.02.16 CB000002369 1.00 110 000,00
1876 CB0000006 13.02.16 CB000002529 1.00 110 000,00
1876 CB0000006 13.02.16 CB000002531 1.00 110 000,00
1882 CB0000007 13.02.16 CB000000754 1.00 110 000,00
1878 CB0000007 13.02.16 CB000002455 1.00 140 000,00
1877 CB0000007 13.02.16 CB000002589 1.00 20 000,00
1882 CB0000007 13.02.16 CB000002842 1.00 120 000,00
1911 CB0000006 15.02.16 CB000001661 2.00 270 000,00
1910 CB0000006 15.02.16 CB000002387 1.00 140 000,00
1910 CB0000006 15.02.16 CB000002768 1.00 120 000,00
1919 CB0000007 16.02.16 CB000000646 1.00 110 000,00
1916 CB0000007 16.02.16 CB000002089 1.00 110 000,00
1916 CB0000007 16.02.16 CB000002104 1.00 110 000,00
1916 CB0000007 16.02.16 CB000002644 2.00 180 000,00
1922 CB0000006 17.02.16 CB000000374 1.00 220 000,00
1926 CB0000006 17.02.16 CB000000586 1.00 220 000,00
1925 CB0000006 17.02.16 CB000002678 1.00 270 000,00
1925 CB0000006 17.02.16 CB000002836 1.00 120 000,00
1930 CB0000007 17.02.16 CB000000595 1.00 220 000,00
1928 CB0000007 17.02.16 CB000002166 1.00 140 000,00
1930 CB0000007 17.02.16 CB000002336 1.00 140 000,00
1930 CB0000007 17.02.16 CB000002838 1.00 120 000,00
и не связная база
Бонусов(справочник)
ProductSet:
LOAD ID_ProductSet,
ProductSet_Count,
Pr_SetBonus
FROM………… (table is ProductSet);
ID_ProductSet ProductSet_Count Pr_SetBonus
1 1 500
2 2 1 500
3 3 2 500
4 4 3 500
5 5 5 000
6 6 5 000
7 7 5 000
Каждому ID_Order по соответствующему ID_Sellers и Date может соответствовать от 1 и более ID_Product
нужно создать отдельную не связную новую таблицу ХХХ:, которую потом связать с ProductSet:
В таблице ХХХ: должны остаться те же поля из Orders: ID_Order, ID_Sellers, Date, (схлопнутые Discinct).
Поля: Product_sum меняется на Or_sum и суммирует Product_sum ,
Product_ count меняется на Or_count и суммирует Product_ count ,
Вместо ID_Product появится новое поле ID_ProductSet (через которое потом связываться) подсчитывает ID_Product строки
В итоге должна получится такая табл.
ID_Order ID_Sellers Date ID_ProductSet Or_count Or_sum
1884 CB0000006 13.02.16 2 2 360 000,00
1876 CB0000006 13.02.16 9 9 990 000,00
1882 CB0000007 13.02.16 2 2 330 000,00
1878 CB0000007 13.02.16 1 1 140 000,00
1877 CB0000007 13.02.16 1 1 20 000,00
1911 CB0000006 15.02.16 1 2 270 000,00
1910 CB0000006 15.02.16 2 2 260 000,00
1919 CB0000007 16.02.16 1 1 110 000,00
1916 CB0000007 16.02.16 3 4 400 000,00
1922 CB0000006 17.02.16 1 1 220 000,00
1926 CB0000006 17.02.16 1 1 220 000,00
1925 CB0000006 17.02.16 2 2 390 000,00
1930 CB0000007 17.02.16 3 3 480 000,00
1928 CB0000007 17.02.16 1 1 140 000,00
Почему именно нужна такая таблица. По полю ID_ProductSet потом нужно соединить (Concatenate) таблицу ProductSet: и получить
ID_Order ID_Sellers Date ID_ProductSet Or_count Or_sum Pr_SetBonus
1884 CB0000006 13.02.16 2 2 360 000,00 1000
1876 CB0000006 13.02.16 9 9 990 000,00 2500
1882 CB0000007 13.02.16 2 2 330 000,00 1000
1878 CB0000007 13.02.16 1 1 140 000,00 500
1877 CB0000007 13.02.16 1 1 20 000,00 500
1911 CB0000006 15.02.16 1 2 270 000,00 500
1910 CB0000006 15.02.16 2 2 260 000,00 1000
1919 CB0000007 16.02.16 1 1 110 000,00 500
1916 CB0000007 16.02.16 3 4 400 000,00 1500
1922 CB0000006 17.02.16 1 1 220 000,00 500
1926 CB0000006 17.02.16 1 1 220 000,00 500
1925 CB0000006 17.02.16 2 2 390 000,00 1000
1930 CB0000007 17.02.16 3 3 480 000,00 1500
1928 CB0000007 17.02.16 1 1 140 000,00 500
После, по полученной таблице уже строить аналитический график.
Если кто-то что-нибудь посоветует, буду очень признательна.

A: Код:
sum(Product_sum) as Or_count,
sum(Product_count) as Or_count,
а
Код:
sum(Product_sum) as Or_Sum,
sum(Product_count) as Or_count,

Q: Второй день бьюсь с проблемой при загрузке данных.
Имеется подобный скрипт.
Проблема в последней строке — не работает!
Возможно я пошел не тем путем, но все же — может у кого есть идея?

Level1:
LOAD GR_ID as GR_ID1,
GR_NAME, P_GR_ID
Resident
Level
Where P_GR_ID=0;

Level2:
LOAD GR_ID as GR_ID2,
GR_NAME, P_GR_ID
Resident
Level
WHERE
match (P_GR_ID, SELECT GR_ID1 FROM Level1);

A: Описание функции Match в справке может помочь найти правильное решение.

Q: подскажите возможно ли в QlikView искать определенное слово в ячейке и при нахождение записывать результат в другую ячейку.
Например из ячейки А(Янтарный замок) найти слово замок и записать в ячейку Б(Замки)

A: Вариантов решения задачи может быть несколько.
Вот самый простой, с условностями.
Код:
maptable:
Mapping LOAD * INLINE [
F1,F2
баннеров, Баннер
баннера, Баннер
плакатов, Плакат
];

table1:
load * Where not Match([Б], ‘NoKeyWord’);
LOAD *,ApplyMap(‘maptable’,SubField([А],’ ‘),’NoKeyWord’) as [Б] INLINE [
А
Закупка баннеров
Приобретение баннера
закупка плакатов
];

Q: Столкнулся со следующей проблемой: собираю уникальные (distinct) значения даты-времени (timestamp) из разных источников в одну таблицу с полями «host» и «event_date». Затем привожу ее к виду «host», «event_date_from», «event_date_to» следующим скриптом:
Код:
LOAD
host_name,
event_date_from,
event_date_to,
Interval(event_date_to-event_date_from,’hh:mm:ss’) as event_duration;
LOAD
host,
Timestamp(event_date) as event_date_from,
Timestamp(If(Previous(host)=host,Previousevent_date)-(1/86400),’$(vNow)’)) as event_date_to
Resident events
Order By host, event_date desc;
Т.е. в отсортированной по дате (по убыванию) таблице, для каждого события, в качестве event_date_to беру предыдущий event_date и вычитаю из него секунду. Для самого последнего события event_date_to равняется текущему времени.[/code]

Так вот, не смотря на то, что беру уникальные значение по Timestamp (SET TimestampFormat=’DD.MM.YYYY hh:mm:ss’), закрадываются такие значения, которые в числовом представлении отличаются на миллисекунды, а timestamp у них одинаковый. Из-за чего, после преобразования точность event_duration равна миллисекундам, т.е. есть значения менее секунды или между секундами. Из-за этого, в свою очередь, появляются одинаковые event_duration в формате ‘hh:mm:ss’, однако разные в номерном представлении.

Откуда берутся миллисекунды? Я уже пытался все округлять до секунд путем
Код:
LOAD
host_name,
Timestamp(Floor(event_date_from*86400)/86400) as event_date_from,
Timestamp(Floor(event_date_to*86400)/86400) as event_date_to;
Не помогает.

A: Привет, время время может хранится числом секунд, миллисекунд , наносекунд.
Выясните как хранится время в источнике, какое число соответствует какой дате.
И если оно не в секундах, то потребуется избавиться от лишних мгновений, разделить на 10 в какой-нибудь степени и дальше работать с округленным, целым числом

Q: Есть две расчитанных таблицы из загруженных данных:

1) Ключ|ЗначениеX|Вычисление1.1|Вычисление1.2|ИтогТабл1
2) Ключ|ЗначениеX|Вычисление2.1|Вычисление2.2|ИтогТабл2

Существует ли возможность объединить их и получить обощеную таблицу вида:

Ключ|ИтогТабл1|ИтогТабл2

A: Привет, конечно же возможно.
Почитайте про Join
http://help.qlik.com/ru-RU/qlikview/12.0/Subsystems/Client/Content/combine-tables-with-join-keep.htm
http://help.qlik.com/ru-RU/qlikview/12.0/search/?q=join

Q: Через R сделал небольшой пример по ассоциативным правилам.Получил результат (screen_7).Подскажите пожалуйста,каким образом можно применить строковые функции,чтобы раздробить столбец Rules на 2 столбца(screen_8).

A: Можете воспользоваться функцией Subfield() .
Пример:
SET vTest = ‘»1″,»{2} => {7}»,0.125,1,2.66666667′;
SET vStr = SubField(vTest ,’,’,2)
(переменная vStr в данном случае будет равна «{2} => {7}»)

Выдержка из руководства:

subfield(s, ‘delimiter’ [ , index ] )
В этой версии с тремя параметрами данная функция скрипта возвращает определенную подстроку
большей строки s с разделителем «delimiter». index — дополнительное целое число, обозначающее
подстроку, которая должна быть возвращена. Если index отсутствует, при использовании subfield в
выражении поля в операторе load функция subfield укажет оператору load на автоматическое создание
одной полной записи для каждой подстроки в s.
В версии с двумя параметрами функция subfield создает одну запись для каждой подстроки, которая
может быть получена для строки s большего размера с разделителем «delimiter». При использовании
нескольких функций subfield в одном операторе load будет получено декартово произведение всех
сочетаний.
Примеры:
(для трех параметров)
subfield(S, ‘;’ ,2) возвращает ‘cde’, если S — ‘abc;cde;efg’
subfield(S, ‘;’ ,1) возвращает NULL, если S — пустая строка
subfield(S, ‘;’ ,1) возвращает пустую строк, если S — ‘;’

Q: У меня есть таблица с двумя полями:
1. Номер заказа
2. Время оформления (в формате чч:мин)

Вопрос — как мне рассчитать в какие интервалы времени больше всего заказов. Или сделать интервалы часовые и посмотреть кол-во заказов каждый час в течение 24 часов?
Нужно ли включать это время в календарь и как?

A: Либо, если время задано текстом, просто выделить часовую составляющую 02:30 = 02.
Для облегчения восприятия можно задать интервалы, например 02:30 = «с 2 до 3» и используя таблицы сопоставления создать новое измерение.
Календарь в этом случае менять не требуется.


Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
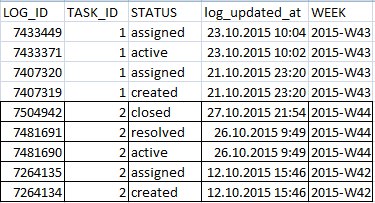
FAQ по скрипту Qlik Sense/Qlik View часть 2

Q: Необходимо выборку значений распределить в диаграмме по заранее неизвестным (расчетным) группам/кластерам.
Пример. Есть выборка значений от 1 до 100, в группе 1-10 количество значений 15, в группе 11-24 количество значений 35, в группе 25-33 количество значений 55 и т. д., т. е. необходим график похожий на нормальное распределение по количеству значений из выборки.
Как привязать расчетное количество из выборки к конкретному расчетному интервалу кластера значений?

A: Выражения вычисляются по измерениям, а в измерениях по какому критерию считать суммы?
Для этих целей следует использовать функцию aggr(), возвращающую массив значений, который уже будет входящим параметром для class().
Т.е. получится конструкция :
Код:
class(
aggr(
sum()… // выражения для расчета по измерениям указанным в следующей строк
,измерения для группировки в aggr()
,100)

Начните с простых выражений для построения измерений

Q: Как сделать диапазон даты, ну т.е. ДатаС и ДатаПо, которую я могу вводить вручную. И желательно чтобы вводилось в формате даты, а не в текстовом формате.
Вроде видел уже такую тему, но не смог найти еще раз.

A: Возможно подойдет данное решение: сначала вводим от и до (смотреть прикрепленный файл) и дальше код.
//LET v_Date_Min = 42736; // 01.01.2017
//LET v_Date_Max = 43100; // 31.12.2017

LET v_Date_Min_N = Num(v_Date_Min); // 01.01.2017
LET v_Date_Max_N = Num(v_Date_Max); // 31.12.2017

Dates:
LOAD $(v_Date_Min_N) as MinDateN,
$(v_Date_Max_N) as MaxDateN,
Date($(v_Date_Min_N), ‘DD.MM.YYYY’) as MinDate,
Date($(v_Date_Max_N), ‘DD.MM.YYYY’) as MaxDate
AutoGenerate(1);

FOR d = $(v_Date_Min_N) to $(v_Date_Max_N)
Period:
LOAD Date($(d), ‘DD.MM.YYYY’) as DAY,
‘W’ & Num(Week($(d)), 00) as WEEK,
Month($(d)) as MONTH,
Year($(d)) as YEAR
AutoGenerate(1);
NEXT d

Q: Как можно получить названия полей при экспорте с экселя, чтобы они стали уже значениями нового поля?
сводную таблицу хочу превратить в обычную.

A: CrossTable(Объект, Количество, 2)
LOAD * FROM
[Преобразование сводной таблицы.xlsx]
(ooxml, embedded labels, table is Лист2);

Q: Сталкивались ли вы в своей работе с проблемой того,что пользователь предоставляет данные в ексель файлах с разрозненными наименованиями полей,например городов или названия клиентов написанны в произвольной форме. Например один и тот же клиент может идти с полным названием,с сокращенным,с припиской ооо в начале, в конце, совсем без нее,с ошибками в названиях И так далее.Или есть адрес,откуда нужно забрать город,но адреса так же не унифицированны и написаны произвольно.Как можно справиться с такой проблемой,мэпринг получается очень большой и трудозатратный,так как в файлах тысячи строк,а функции subfield и другие строковые функции не получается примнгить из-за сильной неструктурированности полей?

A: Организацией порядка при вводе данных.

Q: Есть таблица: объект, артикул, дата, элементы товародвижения, остатки. Хочу удалить при первоначальном и при инкрементальном проходе нули остатков перед первым товародвижением.

При инкрементальном чуть больше код, а именно:
Код:
T8:
load *
,if(ARTICLE<>peek(‘ARTICLE’) and Flag=1,1,
if(ARTICLE<>peek(‘ARTICLE’) and TotalDailyRest<>0, 1,
if(ARTICLE<>peek(‘ARTICLE’) and Flag<>1, 0,
if(ARTICLE=peek(‘ARTICLE’) and TotalDailyRest<>0, 1,
if(ARTICLE=peek(‘ARTICLE’) and Peek(Flag) = 1,1,0))))) as Flag
Resident T7
order by OBJECT, ARTICLE, CREATEDAT
;

Т.е. при Flag = 0 в дальшейшем удалятся строки.

Проблема, что нельзя использовать ARTICLE<>peek(‘ARTICLE’) , т.к. не числа. Что можно взамен использовать? Артикулы как текст, вида 068770.

A: Стоп, почему нельзя использовать peek() с текстом?
Все прекрасно работает.

Следует учитывать сортировку и переходы по ключевым значениям верхнего уровня. В вашем примере это OBJECT.

Q:Хочу сделать обновление в зависимости от времени. Если обновляем в день создания текущего файла, или до 3х ночи следующего дня — то шаг обновления не делаем.

Не работает условие:
Код:
Let IH = 3;
Let DateLastData = date(FileTime(a)-MakeTime(IH));
If date(today(1)-MakeTime(IH)) > DateLastData then

У меня файл создан 28.02.2017 18:34, сейчас 01.03.2017 1:37, то есть по факту в условии будет 28.02.2017 > 28.02.2017, но почему то QS считает истиной.

A: Проводите сравнение в числовом формате.
Дата — это целая часть числа, а время — дробная.

Q: Подскажите, пожалуйста, можно ли «удалять» переменные скрипта после его выполнения (в частности те, что используются в «For each — Next»)- с тем, чтобы они не перегружали обозреватель переменных на втором уровне?
Спасибо!

A: Можно удалить макросом. Например:
Код:
sub test

ActiveDocument.RemoveVariable «v1»
end sub

Q: Столкнулась с проблемой и не знаю как решить.
Заранее извиняюсь, если решение есть на форуме и я не нашла его.

Есть данные из 1С вида:

ФИО Состояние СостояниеЗавершения ДатаПереходаНаСтатус
ФИО1 Отпуск Работает 23.05.2016
ФИО2 Увольнение 01.01.2001
ФИО3 Невыходы Работает 27.05.2016
ФИО4 Увольнение 01.01.2001
ФИО5 Отпуск Работает 31.05.2016
ФИО6 Работает 01.01.2001
ФИО7 Отпуск Работает 23.05.2016
ФИО8 Отпуск Работает 12.05.2016
ФИО9 Отпуск Работает 31.05.2016
ФИО10 Отпуск Работает 26.05.2016
ФИО11 Невыходы Работает 31.05.2016
ФИО12 Отпуск Работает 02.05.2016
ФИО13 Отпуск Работает 10.05.2016
ФИО14 Отпуск Работает 23.05.2016
ФИО15 Невыходы Работает 31.05.2016
ФИО16 Отпуск Работает 16.05.2016
ФИО17 Невыходы Работает 13.05.2016
ФИО18 Невыходы Работает 31.05.2016
ФИО19 Невыходы Работает 22.05.2016
ФИО20 Отпуск Работает 14.05.2016
ФИО21 Работает 01.01.2001
ФИО22 Работает 01.01.2001
ФИО23 Отпуск Работает 31.05.2016
ФИО24 Невыходы Работает 10.05.2016
ФИО25 Увольнение 01.01.2001

Сотрудники двигаются по статусам и надо подсчитать количество сотрудников по каждому статусу на период (Месяц).
С увольнением проблем нет, человек уволился и уволился, так же с прогулами, они нас интересуют конкретно за период.
Но в статусе работает нам нужны люди, которые находятся сейчас в статусе работают (делаю отбор статусов по последней дате у каждой конкретной ФИО) и которые ДО периода не меняли этот статус ни на какой другой.
Получается, выбирая период, мне нужно что бы подтягивались и данные до.
Вопрос как сделать.

A: Честно говоря, не совсем понятна исходная таблица.
ФИО повторяются? Перечислены все статусы?
Из какого источника формируется таблица? Из Отчета?

В 1С ЗУП данные о перемещениях и состояниях сотрудников хранятся в регистрах сведений.
Я бы рекомендовал использовать их для получения сведений.
Но можно решить задачу и на вашей таблице.
Можете подготовить контрольный пример на 1-2 ФИО?

Q: Есть поле провайдер с N-м числом значений. Надо создать группы из этих значений и включить их в список, чтобы в дальнейшим делать выборки по группам. Как это сделать?

A: Можно выгрузить в Excel, заполнить поле по группам и загрузить обратно.

Q: Как реализовать QlikView аналог SQL запроса работая с таблицами из QVD.
получаю данные в несколько QVD файлов.
Тут основной вопрос это как реализовать вложенный запрос для подсчета количества покупок в чеке???
Запрос:
Код:
Select
(SELECT
Count(*)
FROM
pos.order_client,
pos.wares_order
WHERE
order_client.code_order = wares_order.code_order AND
order_client.id_workplace = wares_order.id_workplace AND
order_client.code_shop = wares_order.code_shop) AS «Кол-во позиций»,
order_client.date_receipt AS «Дата чека (если чек не выбит)»,
order_client.number_receipt AS «Номер чека(если чек выбит)»,
order_client.date_order AS «Дата покупки»,
order_client.sum_order AS «Сумма чека»
pos.order_client.code_order AS «id_Код чека»,
order_client.code_client AS «ID_Код клиента»,
order_client.code_shop AS «ID_Код магазина»,
pos.order_client.id_workplace AS «ID_Код кассы»
FROM
pos.order_client;

A: Можно сделать так:

Код:
order_client:
LOAD
code_order,
id_workplace,
code_shop,
date_receipt,
number_receipt,
date_order,
sum_order,
code_client
FROM [order_client.qvd];

NoConcatenate
wares_order:
LOAD
code_order,
id_workplace,
code_shop,
RowNo() as номерСтроки
FROM [wares_order.qvd];

LEFT JOIN(order_client)
LOAD
code_order,
id_workplace,
code_shop,
Count(номерСтроки) as «Кол-во позиций»
Resident wares_order
Group by
code_order,
id_workplace,
code_shop;

DROP TABLE wares_order;

Q: Тяну данные из PostgreSQL, там поле типа «timestamp without time zone».
Нужно получить название месяцев, что бы они сортировались не по алфавиту, а по календарю. то есть просто заменить кейсом на на названия — не вариант.
Пробую так:
Код:
Month(order_client.date_order) As «Месяц»,
Получаю ошибку: ErrorMsg: ERROR: function month(timestamp without time zone) does not exist;
Кто сталкивался и как исправить?
Вот пробую так (подсовываю отформатированую дату):
Код:
Month(date#(order_client.date_order, ‘DD.MM.YYYY’)) As «Месяц»
Но в итоге все равно ошибка (он почему то функцию принимает за название поля):
SQL##f — SqlState: 42703, ErrorCode: 7, ErrorMsg: ERROR: column «date» does not exist;
Error while executing the query

A: Дату возьмите, и с ней уже будете работать средствами клика.

Q: Т.е я разобрался в примере из документации.
Но в контексте данного кода не могу разобраться — Что именно она делает? :
Код: [Выделить]
tmp1:
LOAD min(Date(Date#(dt,’YYYYMMDD’))) as ‘DateStart’, max(Date(Date#(dt,’YYYYMMDD’))) as ‘DateEnd’ Resident GOODS_MOVEMENT;

LET Date_Start = peek(‘DateStart’,0,’tmp1′);
LET Date_End = peek(‘DateEnd’,0,’tmp1′);
LET vStart = floor(Date_Start);
LET vEnd = floor(Date_End);
LET vNumOfDays = vEnd — vStart + 1;
//DROP Table tmp1;

A: Согласно описанию и своему предназначению peek(‘DateStart’,0,’tmp1′) возвращает значение переменной DateStart из первой строки/записи ( 0 обозначает первую запись) таблицы с именем tmp1.

Q: Подскажите пожалуйста,каким образом можно вывести поля YearMonth,YearQuarter ?

CalendarD:
Load

Код:
As PeriodD
,[MonthCode] As MonthD
,[MonthName] as MonthNamesD
,[Year] as [YearD]
,Quarter as QuarterD
;
SQL SELECT *

Поле [code] as PeriodD имеет следующий вид (рис_1)
Пробовал выводить нужные мне поля методом: date(monthstart(Code), ‘MMM YYYY’) as MonthYearD
…но он явно не подходит.

A: http://qlikview-forum.ru/qvf/index.php/topic,11.0.html

Q: Есть столбец, где хранятся номера, нужно на уровне загрузочного скрипта, к этой таблице прикрепить текст.

Пример:
122121 -> МСК122121

Ни как не могу найти функцию, которая бы помогла данную задачу решить.

A: МСК’&ПолеТаблицы as НовоеПоле

Q: Проблема следующая:
Есть несколько однотипных файлов, разложенных по разным подпапкам в одной папке.
Есть ли возможность Загружать в qlikview все эти файлы одним оператором LOAD и при этом ещё записывать в отдельное поле имя подпапки, откуда загружен каждый файл?

A: Скачайте QVC и посмотрите функцию dodir() вроде бы, + там много интересных функций.
https://github.com/RobWunderlich/Qlikview-Components

Q: Есть ассортимент из 5 товаров (SKU) и база клиентов 3 магазина. Каждый из магазинов в определенный временной период закупает определенный ассортимент SKU определенного количества.
Требуется рассчитать Общую проданную дистрибуцию за отчетный период (день/месяц/квартал/год/любой указанный период).

Пример,
Магазин 1 закупил 5 SKU Первая накладная — 3 SKU, вторая накладная — 3 SKU (два новых и одно из прошлой накладной.
Магазин 2 закупил 4 SKU Первая накладная — 2 SKU, вторая накладная — 2 SKU. Все купленные SKU уникальные.
Магазин 3 закупил 1 SKU Первая накладная — 1 SKU, вторая накладная — 1 SKU. SKU одинаковые.

Общая проданная дистрибуция за период равна Проданная дистрибуция Магазин 1 + Проданная дистрибуция Магазин 2 + проданная дистрибуция Магазин 3 =5+4+1= 10 SKU.

Задача сводится к подсчету уникальных SKU по всем накладным клиентов в отчетный период и суммированию уникальных купленных SKU по всем клиентам.

A: Код:
sum(
aggr(count(distinct SKU), Магазин )
)
Чтобы было проще обсуждать проблему и находить решение желательно выкладывать образец данных.
В любом табличном формате — csv, xls* или фрагмент скрипта загрузки load inline …

Q: Как реализовать инкрементальную загрузку для таблицы транзакций из SQL базы?

Исходные данные:
В базе данных есть таблица транзакций с полями:
№, Дата, Сумма
1 01.04.2016 08:05:47 500
2 03.04.2016 10:09:12 350
….
235 12.10.2016 15:05:21 740

Задача:
Создать скрипт загрузки в QlikView, который позволить загружать из базы данных только новые данные (данные с последней успешной загрузки), а остальные — из qvd-файла.

A: если дата из вашего источника однозначно определяет новую запись или измененную, то можете опираться на нее.
Значения $(LastExecTime) и $(BeginningThisExecTime) берете из существующего Qvd и скрипта.

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
FAQ по скрипту Qlik Sense/Qlik View часть 1

Q: Задача:
Есть дата начала некоторого процесса с точностью до секунд
Есть дата конца этого же процесса с точностью до секунд
Пусть
date1 = 42738,61556713 или 03.01.2017 14:46:25
date2 = 42738,93556713 или 03.01.2017 22:27:13

Требуется посчитать в часах/минутах/секундах — сколько по времени длился процесс

Иными словами перевести значение разницы 42738,93556713-42738,61556713 = 0,32 в количество секунд либо минут либо часов

A: Смотрите функцию Interval : Interval ? QlikView

Q: Подскажите почему расчет переменной X в скрипте дает NULL?

Продажи:
Load * Inline [
IDКлиента|ДатаОплаты|Сумма
101|02/11/2010|100
101|01/12/2011|200
101|02/01/2012|50
102|02/01/2012|20
102|01/04/2012|150
103|02/11/2013|100
] (delimiter is ‘|’);

Let X=Peek(IDКлиента,0,’Продажи’);

A: Первый параметр в кавычки заключи.
Имя поля, для которого требуется возвращаемое значение. Вводимое значение необходимо задать в виде строки.

«Peek — функция скрипта ? Qlik Sense»

Q: В правах доступа для пользователя прописано
acc.PERIOD, acc.BRANCH и acc.CODE
В данных поля
dat.PERIOD, dat.SRC_BRANCH, dat.DEST_BRANCH, dat.SRC_CODE, dat.DEST_CODE
Как организовать SECTION APPLICATION доступ, чтобы был доступ ко всем записям
acc.PERIOD=dat.PERIOD and
(acc.BRANCH = dat.SRC_BRANCH or acc.BRANCH = dat.DEST_BRANCH)
and
(acc.CODE = dat.SRC_CODE or acc.CODE = DEST_CODE)

A: Склеил поля прав Подразделение&’$’& ТовГруппа и дважды пробежался по фактам сначала с одной стороны, потому с другой. Получил для каждого пользователя список фактических ключей Подразделение1&’$’& ТовГруппа1&’$’&Подразделение2&’$’& ТовГруппа2. Затем склейку заменил autohash256 и mapping, чтобы покороче ключ был.

Q: Кто может помочь? Проблема такая: есть таблица с данными прохода сотрудников на проход. Данные: личный номер сотрудника, время прохода турникета, направление (вошел или вышёл). В день 10-15 тысяч записей. Задача: надо сгрупировать по номеру сотрудника, по отсортировать времени и к каждой записи даты и времени входа приписать следующую запись выхода, и исходя из этих двух данных приписать время пребывания на объекте.
Благодарю за внимание!
Кто может помочь? Проблема такая: есть таблица с данными прохода сотрудников на проход. Данные: личный номер сотрудника, время прохода турникета, направление (вошел или вышёл). В день 10-15 тысяч записей. Задача: надо сгрупировать по номеру сотрудника, по отсортировать времени и к каждой записи даты и времени входа приписать следующую запись выхода , и исходя из этих двух данных приписать время пребывания на объекте .
На работаю
Благодарю за информацию Внимания!

A: Эту задачу можно решить при помощи сортировки данных в скрипте загрузки. Конечный код конечно будет зависеть от того, есть ли в данных «проблемные места» (например, когда человек зашел в обход системы учета, а вышел через нее, и у него подряд 2 события выхода стоят). Но в общем случае я решал бы ее так:

dataTmp1: //Загружаем исходные данные
LOAD
RowNo() as PassID, //Проставляем нумерацию для уникального определения каждой строки
PERSON_ID,
BORDER_CROSS_DATE as CrossTS,
date(floor(BORDER_CROSS_DATE)) as Day,
DIRECTION_NAME
FROM [lib://Demo (bbsales-u122707_qlik.acc)/In-Out.csv]
(txt, codepage is 1251, embedded labels, delimiter is ‘,’, msq);

dataTmp2:
NoConcatenate
load
*
Resident dataTmp1 order by PERSON_ID,CrossTS asc; //Сортируем данные по сотруднику, а потом по дате прохода, по возрастанию

dataTmp3:
NoConcatenate
load *,
if(PERSON_ID<>Previous(PERSON_ID) and DIRECTION_NAME=’out’,1,0) as delMark //Отмечаем первую запись по сотруднику, если она имеет направление out, чтобы всегда начинать со входа
Resident dataTmp2;

data:
NoConcatenate
load *,
if(PERSON_ID=Previous(PERSON_ID) and DIRECTION_NAME=’out’,alt(-(Previous(CrossTS)-CrossTS),0),0) as [InTime] //Для каждой строчки выхода считаем разность от ее времени до времени предыдущей записи, ставим знак минус, потому что время выхода больше, чем время входа, чтобы в итоге получить положительное значение длительности.

Resident dataTmp3 where delMark=0; //Обрезаем первую запись по сотруднику, если она имеет направление out, чтобы всегда начинать со входа

//Дропаем временные таблицы
drop Tables dataTmp1, dataTmp2, dataTmp3;

Q: Подскажите, пожалуйста, как реализовать динамику показателя в разрезе месяцев, но чтобы показатель считался за год. Т.е.
январь 2017 — сумма с 01.02.2016 по 31.01.2017
февраль 2017 — сумма с 01.03.2016 по 28.02.2017
март 2017 — сумма с 01.04.2016 по 31.03.2017

Выражение
Код:
sum({<Дата = {">$(=MonthEnd(AddYears(max(Дата), -1)))»}, Год=, Месяц=>}Measure)
работает только, если нет измерения Месяц в таблице, т.к. игнорируется только выборка по году и по месяцу, но не измерение. Есть ли варианты сделать это с помощью Set Analysis?

A: Поищите информацию про метод «asofdate» для расчета «скользящих» показателей.
Суть в том, что для каждой даты должны быть соответствия с предыдущими датами .
Здесь подробно описано решение.
Также, можно использовать библиотеку процедур QVC для построения календаря (asoftable).

Q: Подскажите, плз, кто знает.
Опубликовал приложение в потоке, создал в Qlik Management Console задачу на загрузку данных по регламенту, но данные, которые грузятся по rest-коннектору не отображаются на листе, а данные, которые грузятся из qvd-файлов — отображаются. Хотя, если загрузить через диспетчер данных — данные есть все, что нужно.

Почему так происходит?
Неужели, прежде, чем грузить данные в память их нужно поместить в qvd-файл?

A: Пропишите все этапы загрузки данных через скрипт

Q: Есть вот такой столбик в выгружаемом файле.

Минск Слоним 18.08.17 №ТТН 4628907, 4628908 № бланка 90026854
Минск Брагин 18.08.17 №ТТН 4628905, 4628904 № бланка 90026855
Минск Столбцы 18.08.17 №ТТН 4628906 № бланка 90026873
Минск Хойники 18.08.17 №ТТН 4628875 № бланка 90026850

Мне необходимо из этого массива только номера ТТН , можно ли их как то «выдернуть» в отдельный столбец для дальнейшего использования ?
Причем в некоторых случаях ТТН идут через запятую.

A: Необходимо проверить все значения.
Если есть системность, например номера между №ТТН и №, то можно за это зацепиться и выдернуть номера используя TextBetween().
Пример по файлу ниже:
Код:
LOAD *,
trim(SubField(TextBetween(наименование,’№ТТН’,’№’ ),’,’)) as НомерТТН;
LOAD recno() as IDRow,
наименование,
ед_из,
вес,
обьем_вес,
цена_БНДС,
сумма,
НДС,
сумма_НДС,
стоимость_СНДС
FROM
[пример_qv.xlsx]
(ooxml, embedded labels, table is Лист1);

Q: Подскажите пожалуйста как добиться вот такого результата.
Причем преобразование необходимо провести на уровне скрипта.
Задача:
1. Имеем табличку, где сложены id товара и дата его наличия на складе.
2. id товара всегда уникальна
3. Если товар поступил на склад, то делается запись в таблице, если товар ушел со склада, то запись то же пропадает.
4. Нужно пронумеровать дни, 1 день, 2 день, и т.д. И если товар есть в наличии, то поставить 1, если нет записи то 0.

A: Необходимо отсортировать по ID товара и дате, и пронумеровать записи.
Выражение примерно такое:

if(id=peek(id),День+1,1) as День,

Можно сделать таким образом:
СкладTemp:
Load * inline
[
id,data
20,07.01.2016
14,01.01.2016
14,02.01.2016
14,03.01.2016
14,04.01.2016
14,05.01.2016
15,01.01.2016
15,02.01.2016
15,03.01.2016
15,04.01.2016
16,01.01.2016
16,02.01.2016
16,03.01.2016
20,06.01.2016
];

NoConcatenate
Склад:
LOAD
id as ID, //Field1
// data as DATA,
‘День ‘ & Day(data) & ‘ (‘ & month(data) & year(data) & ‘)’ as DAY, //Attribute
‘1’ as IN_STOCK //Value
Resident СкладTemp;

DROP TABLE СкладTemp;

temp1:
generic load * resident Склад;

result:
load distinct ID resident Склад;

drop table Склад;

FOR i = 0 to NoOfTables()
TableList:
LOAD TableName($(i)) as Tablename AUTOGENERATE 1
WHERE WildMatch(TableName($(i)), ‘temp1.*’);
NEXT i

FOR i = 1 to FieldValueCount(‘Tablename’)
LET vTable = FieldValue(‘Tablename’, $(i));
LEFT JOIN (result) LOAD * RESIDENT [$(vTable)];
DROP TABLE [$(vTable)];
NEXT i

DROP TABLE TableList;
http://i12.pixs.ru/storage/9/6/8/forumpng_6513000_24839968.png
Q:
Есть таблица с данными, отсортирована по Номенклатуре и дате. Нужно вычислить/заполнить данные в скрипте по остаткам на конец дня, на основании остатков за предыдущий день и прихода за конкретную дату. Номенклатуры есть разные, остатки на 01 число месяца также присутствуют (поле Данные).

A: load *, if(папір=peek(папір),Данные+if(isnull(прихід),0,прихід)+if(isnull(peek(zal)),0,peek(zal)),Данные) as zal Resident Ruh Order by папір, Дата ASC;

Q: Необходимо сделать выборку части данных из колонки. Выбирать надо 3 символа из строки, начиная с пятой позиции, но только для тех строк, которые начинаются на 7495.
Т.е.
Из колонки

sip:estrelcova@pit
sip:aic_om@avia
sip:aic_sklad2@aviainter
78124011111
74956171360
79218447811
74952366974
73912001356
79258582548
74997052796

надо отобрать только 617 и 236

Сейчас использую MID, но это ни то, что мне нужно.

A: Используйте условие, типа:
Если 4 левых символа = 7495, то взять три символа с пятой позиции.
Или если в запросе, то используйте where wildmatch(Строка,’7495*’) а в поле уже делайте извлечение подстроки

Q: Коллеги, помогите создать виртуальную таблицу с использованием Autogenerate.

A: А intervalmatch()?

Q: Казалось бы, воспользуйся ты функцией min(Дата счета) и прекращай заниматься ерундой в субботу вечером. Но не все так просто..
Есть еще правило: первым счетом Клиента считается такой счет, дата выставления которого больше даты выставления предыдущего счета на этого Клиента на 365 дней и более.
Пожалуй, это можно было бы реализовать на стадии скрипта загрузки, но в силу того что Счета связаны с Клиентами через несколько таблиц и наличия еще одного правила «на вырост»(в конце), я этого не делаю..
Пытаюсь выкрутить это через анализ множество, но все тщетно.
Пример не работающей формулы, которая по моей задумке должна была бы сработать:
max(
aggr({1<Номер счета = {"=rangesum(Дата счета,-below(Дата счета))>365″}>}
Дата счета,
Клиент, Дата счета(Numeric,Descending)))
)

Ситуацию еще усугубляет наличие 2х типов счетов:разовый(за одну услугу) и групповой(за несколько услуг), которые лежат в разных таблицах и конкатенировать которые пока тоже весьма затруднительно.
Но с этим я как нибудь разберусь уж..

Правило на вырост: первым счетом Клиента по Продукту считается такой счет, дата выставления которого больше даты выставления предыдущего счета на этого Клиента по этому же продукту на 365 дней.
По идее должно выглядеть как-то так:
max(
aggr({1<Номер счета = {"=rangesum(Дата счета,-below(Дата счета))>365″}>}
Дата счета,
Клиент, Продукт, Дата счета(Numeric,Descending)))
)

A: Мой совет — решить в скрипте. Слишком много вычислений в принципе, а еще и с проверкой на диапазон между датами…
Надо будет в едином реестре все счета отсортировать и расставить индексы согласно вашим установкам, причем индексы можно будет сделать разные за один запрос.
И на общий порядковый номер заказа по клиенту, и с периодами и еще с чем-то на будущее…

aggr() с множествами — отличные помощники, но не там где много записей или мало ресурсов.

Q: Занимаюсь проектом на QlikView есть проблемка.
Есть три таблицы — Таб1, Таб2, Таб3
Шаг 1. Первая грузится Таб1, Шаг 2. затем необходимо Таб2 соединить с Таб3, которая в свою очередь забирает данные для обсчета из Таб1. Шаг 3. После этого полученную таблицу на шаге 2 необходимо объединить с Таб 1.

У меня после оператора объединения сразу происходит объединение Таб1 с Таб2 и после этого соединение с Таб3. Как сделать объединение с уже объединенной таблицей Таб2 и Таб3?

A: Зачем мы грузим таб1 если нам надо надо связывать таб2 с производной от таб1?
Можно просто сделать
tmp1:
load * from tab2 ;
//tab3
left join
load * from tab1 ;
concatenate (tmp1) load … from tab1 ;

Найти решение у бизнес-партнера QlikTech (QlikView) в России.

Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
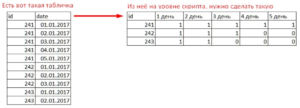
76 queries in 0,292 seconds
Website nonton bokep jepang