 RSS

 4 декабря 2017
 gromych
Q: Подскажите пожалуйста как можно преобразовать текущий вид даты 6 мая 2015 в текстовом формате в такой вид 06.05.2015.
Нам надо ее разобрать на три составляющие.
Для расчленения используйте SubField(), в качестве разделителя — пробел, при это крайние пробелы надо предварительно убрать.
Для формирования формата даты — MakeDate()
Для перевода текстового обозначения месяца в числовое используйте маппинг.
ApplyMap() можно использовать в качестве параметра для MakeDate().
Q: Нахожусь в стадии изучения документации QlikView, но поставленную задачу (вероятно, весьма лёгкую для опытного человека) необходимо выполнить быстрее (а именно сегодня), чем я осилю документацию.
Не уверен, что правильно подобрал заголовок темы. Возможно, есть соврешенно иной подход.
Исходные данные:
Group Value
A 100
A 200
B 330
B 404
B 555
C 600
Я хочу подсчитать количество (не сумму) записей для каждой группы с учётом текущей выборки. Например, диаграмма «Прямая таблица» даёт нужный результат:
Group Count(Value)
A 2
B 3
C 1
Теперь я хочу получить строку вида «A=2,B=4,C=1», чтобы использовать, например, в текстовом объекте. Как это сделать? Прошу подсказать
A: Почитайте про функции: aggr(), concat(), rank, FirstSortedValue(), анализ множеств тоже не помешает.
Q: Есть поле LinkKey2. В этом поле есть данные номенклатурной группы и типов.Каким образом можно,с помощью AutoNumber,извлечь эти поля?Скорее все поле — autonumber(linkkey2) as linkkey2 — написано с ошибкой.
A: Не совсем понятна задача.
Что значит извлечь поля?
Почитайте про функции счетчика
Может autonumberhash128() более подходящая в этом случае функция?
Q: Подскажите,пожалуйста, есть ли такая функция в клике,которая проверяет строчку и если в ней содержаться буквы, то выводит определенное значение, а если нет,то null. Нужно отсортировать строчки где есть только цифры от строчек где содержаться еще и буквы.
A: Вариантов масса, например
if(
len(keepchar ( Field,’0123456789′ ))= len(Field) , значение, null())

Q: Не подскажите как лучше такое реализовать. Есть таблица с заявками с двумя полями id и page. Некоторые заявки дублируются из за особенности работы системы сбора аналитики. Как можно подсчитать уникальное количество id у которого в поле pageприсутствует слово thx-case , слово thx-case и обозначает что это оформленная заявка и одинаковые надо склеить и подсчитать.
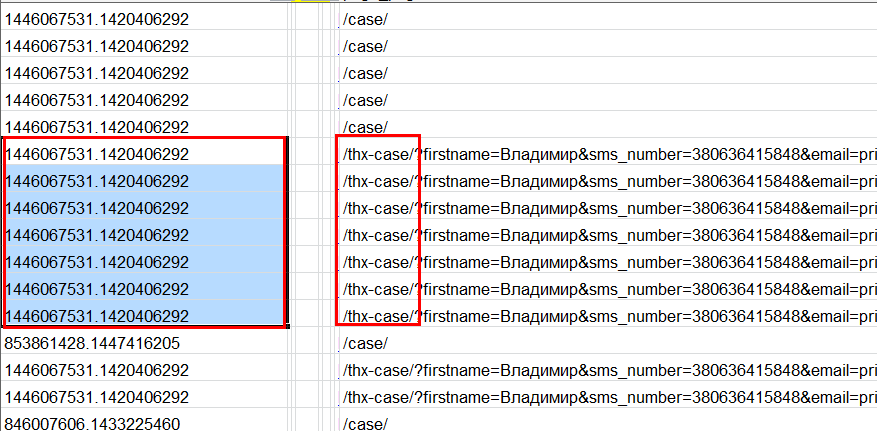
A: load distinct * оставит только уникальные значения.
Q: Есть исходное приложение. Из этого приложения необходимо выгрузить определенные справочники в эксель файл и обезличить их (к примеру холодильник-товар1,телевизор-товар2,Иркутск-Филиал1 и т.д.).После обезличивания данных,необходимо их снова загрузить в исходное приложение.Проблема в том,что когда заношу обезличенные данные в скрипт,а потом нажимаю «Загрузить»,то загрузка происходит с ошибками,т.к. той бд,что в приложении у нас нет.
Вопрос:возможно, есть какие-либо другие способы занести обезличенные данные в скрипт и успешно обновить?
A: Иногда приходиться такое делать.
В основном использую функцию RowNo() в загрузке данных.
Также, иногда нужно исказить и числа, потому можно умножить/поделить и т.д., например, на 1,15 или использовать функцию Rand().
Маленький пример:
Код: [Выделить]
Clients:
LOAD CLIENT_ID,
‘Shop_’ & num(RowNo(), 000) as CLIENT_NAME
From Dict_Clients.qvd (qvd);
Q: Очень нужна ваша помощь.
Есть таблица с данными в виде среза,т.е в таком виде.
Дата, Сотрудник, Вид выплаты, сумма
01.01.15, Иванов, оклад,10000
01.01.15, Иванов, премия,5000
03.03.15, Иванов,премия,1000
05.05.15, Иванов,оклад,15000
Из таблицы такого типа мне нужен оклад сотрудника на каждый месяц, но запись есть лишь тогда,когда оклад либо назначается при приеме на работу,либо при изменении этого оклада,к примеру если человеку его повысили. Как можно решить такого типа проблему? Нужен оклад на каждый месяц.
A: посмотрите примеры использования функции peek(), например в теме по загрузке курсов валют peek() используется для заполнения недостающих записей котировок на выходные дни.
В вашем случае потребуется привязать таблицу к календарю, отсортировать по сотруднику и периоду и заполнить недостающие сведения из предыдущей записи.
Q: Задача звучит просто, но как сделать пока не могу найти.
Задача:
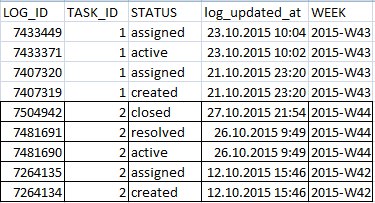
Есть задания (tasks), есть логи изменения их состояний (task_logs)
Выглядит это допустим так:
Мы видим, что task1 (task_id=1) был ‘создан'(created), ‘назначен'(assigned) и ‘взят в работу'(active) в неделю под номером W43.
А task2 был создан и назначен в W42, в W43 с ним ничего не происходило, поэтому нет ни одной записи за эту неделю о изменении его статуса, а в W44 он был решен и закрыт.
Мне же необходимо построить chart с грануляцией по неделям с информацией сколько же в каждую неделю было незакрытых task-ов(т.е. все задания в статусах не равных ‘закрыт’). За W43 у меня есть записи в логах только по одному task-у, но ‘незакрытых’ task-ов должно посчитаться 2, а не 1.
Каким образом можно это сделать? в оракле я б использовала аналитические функции, а тут мне не хватает знаний.
Огромное спасибо за помощь! очень жду ваших советов
A: Первое,что приходит в голову
Сначала перестроить таблицу, так чтобы появилось 2 столбца: BEGIN_wk END_wk:
Примерно так:
Код:
tmp:
LOAD *,
if(id_task=Previous(id_task) , Previous(week), weekname(‘01.01.2100′) ) as END_wk, weekname(log_updated_at) as BEGIN_wk
from task_logs where status=’created’ or status=’closed’
Order by id_task, log_updated_at desc;
interval_table:
load * resident tmp where status=’created’;
drop table tmp;
Затем можно это дело привязать к календарю через
Код:
Intervalmatch (WEEK_FROM_CALENDAR) load BEGIN_WK ,END_WK resident tmp;
Ну и дальше считать через count distinct

Q: Дана таблица. Как можно получить значения соответствующих месяцу коэфф. предыдущего года вместо нулей?
Т.е. в результате вместо нулей должны быть:
may-2015: 1,56 6
jun-2015: 1,658
jul-2015: 0,829
P.s. т.е. тем месяц-годам с конца, у которых отсутствовали продажи взять соотв. коэфф. из предыдущего года.
A: if(Sales=0,peek( ‘Коэф’, -12 ),’Коэф’)
Вроде бы так, если с синтаксисом не напутал, нет доступа к qv в ближайшие часы.
Q: на уровне скрипта нужно исключить все данные где есть слово «тест» в определенном столбце. Слово тест может стоять в начале текста, в конце, в середине. Как правильно сформировать условие?
Код:
WHERE [E] <> ‘Что тут должно сточть?’
A: Код:
where not WildMatch(…)
тестовый скрипт
Код:
test:
LOAD rowno() as %ID, * INLINE [
F1
Это тест
тест это
это тест наверняка
норма
правильная запись
];
NoConcatenate load * resident test where not WildMatch(F1,’*тест*’);
drop Table test;
Q: А чем проблема со временем?
Вам надо брать период с 00:00:00 по 23:59:59
Возьмем период с первого по 14 число октября.
Используя today() мы тем самым стираем время и получаем просто дату 01.10.2015 и т.д.
Так 01.10.2015 — это весь день, т.е. берутся данные с 01.10.2015 00:00:00 по 23:59:59. Конечный дата 14.10.2015. Тут аналогично — данные за весь деть. Тем самым мы получаем данные с 01.10.2015 00:00:00 по 14.10.2015 23:59:59.
Т.е. 01.10.2015 00:00:00 <=DATE_DOC <= 14.10.2015 23:59:59
Т.е. DATE_START <=DATE_DOC <= DATE_END
. Но...у меня не работает today(), если подавать его на вход в SQL-запрос. Если прописать today() как переменные через LET, а потом добавить в него их - то же самое, ошибки, несоответствие формата.
A: а попробуйте еще вот так:
Код:
let v_TodayMinus10 = Date(today() — 10) & ‘ 00:00:00’;
P.s. Скорее всего, действительно, перестали «глубоко вникать» в данный вопрос, так как решение казалось простым… Но на самом деле, может быть по другому.
Q: подскажите как можно высчитать оставшееся время до определенной даты в формате hh:mm:ss?
Допустим оставшееся количество до Нового года.
A: Смотри информацию по interval()
Код:
=interval(YearEnd(today())-today(),’ hh:mm:ss’)
Q: Подскажите как сделать связывание полей в QV11: одно поле содержит покупателей, где записаны их номера примерно в виде 01534211, где первые два символа (01 в данном примере) означают их регион. Также есть поле с этими самыми регионами. В задании присутствует множество покупателей в каждом регионе. Можно ли это сделать как то через скрипт?
A: Не совсем понятно, что нужно получить на «выходе».
Догадываюсь, что хотите разделить регион и покупателей.
Выделить регион в поле: left(Field_01, 2) as Region.
Выделить покупателей в поле: right(Field_01, 6) as Customer.
Будет хорошо, если опишете задачу более детально.
Можно ли это сделать как то через скрипт?
Конечно, ДА.
Как коллега правильно отметил, пример данных помог бы оперативно опубликовать решение по вашей задаче.
Q: Предположим, что у нас есть таблица, которая генерируется скриптом:
Код:
ExampleTbl:
LOAD * Inline [
field1, field2, field3
1,2,3
];
Как, к примеру, обновить field2? Может быть есть какая-то полезная фича? Не смог найти в открытых источниках =(
Обновить поле нужно именно в этой таблице. Возможно есть нестандартный прием? Или опять воротить через JOIN?
A: если такая необходимость возникает можно перезагрузить таблицу в скрипте с обработкой полей по нужному алгоритму и удалением оригинала. В результате останется таблица с измененными полями. Join и не нужен.
Q: Подскажите, пожалуйста, есть ли в скрипте альтернативная функция как ВПР в экселе?
То есть можно ли как-то сравнивать 2 разных текстовых поля в двух разных таблицах?
И если нашлись одинаковые значения, то нужно их вывести.
A: ВПР на английском VLOOKUP (это в Excel). Для QlikView существует аналог:
lookup(‘<Поле, которое показываем>‘,’<Поле в сравниваемой таблице, которое сопадает>‘,<Поле в исходной таблице>,’<Сравниваемая таблица>‘)
Пример:
Код:
Товары:
LOAD * INLINE [
ID Товара, Наименование товара, Цена товара
100, Удочка, 5000
101, Леска, 560
102, Крючок, 40
103, Пассатижи, 90
104, Складной нож, 2500
105, Рюкзак, 3000
106, Поплавок, 150
107, Наживка, 100
108, Кепка, 690
109, Жилет, 1800
110, Резиновая лодка, 7900
111, Фонарь, 2000
];
Транзакции:
LOAD * INLINE [
Номер транзакции, Код товара, Количество
1, 106, 2
2, 107, 1
3, 111, 1
4, 102, 1
5, 102, 1
6, 109, 1
7, 100, 2
8, 103, 1
9, 107, 1
10, 103, 1
11, 100, 1
12, 100, 2
13, 107, 1
14, 110, 2
15, 102, 1
16, 103, 1
17, 109, 1
18, 109, 1
19, 110, 1
20, 103, 1
21, 111, 1
22, 109, 1
23, 108, 1
24, 100, 2
25, 108, 1
26, 101, 1
27, 106, 1
28, 101, 2
29, 105, 1
30, 101, 1
];
[Сумма покупок]:
LOAD [Номер транзакции],
[Код товара],
[Количество],
lookup(‘Наименование товара’,’ID Товара’,[Код товара],’Товары’) as [Наименование товара],
lookup(‘Цена товара’,’ID Товара’,[Код товара],’Товары’) as [Цена товара],
[Количество]*lookup(‘Цена товара’,’ID Товара’,[Код товара],’Товары’) as [Сумма транзакции]
Resident [Транзакции];
DROP Tables [Товары], [Транзакции];
Q: Есть таблиц:
Товар Сумма товара Общая сумма всех товаров Процент от общей суммы
Яйца 25 55 25/55 = 0,45
Кефир 15 55 15/55 = 0,27
Молоко 10 55 10/55 = 0,18
Хлеб 5 55 5/55 = 0,09
Вопрос. Как посчитать накопительную сумму В СКРИПТЕ?
Чтобы получилась таблица вида:
Товар Сумма товара Общая сумма всех товаров Процент от общей суммы Накопительная сумма
Яйца 25 55 25/55 = 0,45 0,45
Кефир 15 55 15/55 = 0,27 0,72
Молоко 10 55 10/55 = 0,18 0,9
Хлеб 5 55 5/55 = 0,09 0,99
Это нужно, чтобы «посчитать» ABC-анализ.
Данную задачу можно решить через Expression, например, вот так — http://www.qlik4life.com/accumulation-in-qlikview/.
Но, более правильнее, рассчитать это в скрипте, так как данных достаточно много да и вообще, так будет правильнее.
A: Думаю, расчет накопительных сумм в таблице выражением будет удобнее
Q: опять возник вопрос по редактированию скрипта загрузки:
В таблице, есть поле дата, которое выглядит так: 2015-08-14 11:50:00
Как на уровне скрипта, привести к виду: 14.08.2015
A:
1.Код:
Date(2015-08-14 11:50:00, ‘DD.MM.YYYY’)
2.
Делаем фильтр вида:
Код:
Month(2015-08-14 11:50:00)
Будут показываться только месяцы
Найти решение у бизнес-партнера QlikTech (QlikView) в России.
Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
 Опубликовано в рубрике