 RSS

 4 декабря 2017
 gromych
Q: Задача:
Есть дата начала некоторого процесса с точностью до секунд
Есть дата конца этого же процесса с точностью до секунд
Пусть
date1 = 42738,61556713 или 03.01.2017 14:46:25
date2 = 42738,93556713 или 03.01.2017 22:27:13
Требуется посчитать в часах/минутах/секундах — сколько по времени длился процесс
Иными словами перевести значение разницы 42738,93556713-42738,61556713 = 0,32 в количество секунд либо минут либо часов
A: Смотрите функцию Interval : Interval ? QlikView
Q: Подскажите почему расчет переменной X в скрипте дает NULL?
Продажи:
Load * Inline [
IDКлиента|ДатаОплаты|Сумма
101|02/11/2010|100
101|01/12/2011|200
101|02/01/2012|50
102|02/01/2012|20
102|01/04/2012|150
103|02/11/2013|100
] (delimiter is ‘|’);
Let X=Peek(IDКлиента,0,’Продажи’);
A: Первый параметр в кавычки заключи.
Имя поля, для которого требуется возвращаемое значение. Вводимое значение необходимо задать в виде строки.
«Peek — функция скрипта ? Qlik Sense»
Q: В правах доступа для пользователя прописано
acc.PERIOD, acc.BRANCH и acc.CODE
В данных поля
dat.PERIOD, dat.SRC_BRANCH, dat.DEST_BRANCH, dat.SRC_CODE, dat.DEST_CODE
Как организовать SECTION APPLICATION доступ, чтобы был доступ ко всем записям
acc.PERIOD=dat.PERIOD and
(acc.BRANCH = dat.SRC_BRANCH or acc.BRANCH = dat.DEST_BRANCH)
and
(acc.CODE = dat.SRC_CODE or acc.CODE = DEST_CODE)
A: Склеил поля прав Подразделение&’$’& ТовГруппа и дважды пробежался по фактам сначала с одной стороны, потому с другой. Получил для каждого пользователя список фактических ключей Подразделение1&’$’& ТовГруппа1&’$’&Подразделение2&’$’& ТовГруппа2. Затем склейку заменил autohash256 и mapping, чтобы покороче ключ был.
Q: Кто может помочь? Проблема такая: есть таблица с данными прохода сотрудников на проход. Данные: личный номер сотрудника, время прохода турникета, направление (вошел или вышёл). В день 10-15 тысяч записей. Задача: надо сгрупировать по номеру сотрудника, по отсортировать времени и к каждой записи даты и времени входа приписать следующую запись выхода, и исходя из этих двух данных приписать время пребывания на объекте.
Благодарю за внимание!
Кто может помочь? Проблема такая: есть таблица с данными прохода сотрудников на проход. Данные: личный номер сотрудника, время прохода турникета, направление (вошел или вышёл). В день 10-15 тысяч записей. Задача: надо сгрупировать по номеру сотрудника, по отсортировать времени и к каждой записи даты и времени входа приписать следующую запись выхода , и исходя из этих двух данных приписать время пребывания на объекте .
На работаю
Благодарю за информацию Внимания!
A: Эту задачу можно решить при помощи сортировки данных в скрипте загрузки. Конечный код конечно будет зависеть от того, есть ли в данных «проблемные места» (например, когда человек зашел в обход системы учета, а вышел через нее, и у него подряд 2 события выхода стоят). Но в общем случае я решал бы ее так: 
dataTmp1: //Загружаем исходные данные
LOAD
RowNo() as PassID, //Проставляем нумерацию для уникального определения каждой строки
PERSON_ID,
BORDER_CROSS_DATE as CrossTS,
date(floor(BORDER_CROSS_DATE)) as Day,
DIRECTION_NAME
FROM [lib://Demo (bbsales-u122707_qlik.acc)/In-Out.csv]
(txt, codepage is 1251, embedded labels, delimiter is ‘,’, msq);
dataTmp2:
NoConcatenate
load
*
Resident dataTmp1 order by PERSON_ID,CrossTS asc; //Сортируем данные по сотруднику, а потом по дате прохода, по возрастанию
dataTmp3:
NoConcatenate
load *,
if(PERSON_ID<>Previous(PERSON_ID) and DIRECTION_NAME=’out’,1,0) as delMark //Отмечаем первую запись по сотруднику, если она имеет направление out, чтобы всегда начинать со входа
Resident dataTmp2;
data:
NoConcatenate
load *,
if(PERSON_ID=Previous(PERSON_ID) and DIRECTION_NAME=’out’,alt(-(Previous(CrossTS)-CrossTS),0),0) as [InTime] //Для каждой строчки выхода считаем разность от ее времени до времени предыдущей записи, ставим знак минус, потому что время выхода больше, чем время входа, чтобы в итоге получить положительное значение длительности.
Resident dataTmp3 where delMark=0; //Обрезаем первую запись по сотруднику, если она имеет направление out, чтобы всегда начинать со входа
//Дропаем временные таблицы
drop Tables dataTmp1, dataTmp2, dataTmp3;

Q: Подскажите, пожалуйста, как реализовать динамику показателя в разрезе месяцев, но чтобы показатель считался за год. Т.е.
январь 2017 — сумма с 01.02.2016 по 31.01.2017
февраль 2017 — сумма с 01.03.2016 по 28.02.2017
март 2017 — сумма с 01.04.2016 по 31.03.2017
Выражение
Код:
sum({<Дата = {">$(=MonthEnd(AddYears(max(Дата), -1)))»}, Год=, Месяц=>}Measure)
работает только, если нет измерения Месяц в таблице, т.к. игнорируется только выборка по году и по месяцу, но не измерение. Есть ли варианты сделать это с помощью Set Analysis?
A: Поищите информацию про метод «asofdate» для расчета «скользящих» показателей.
Суть в том, что для каждой даты должны быть соответствия с предыдущими датами .
Здесь подробно описано решение.
Также, можно использовать библиотеку процедур QVC для построения календаря (asoftable).
Q: Подскажите, плз, кто знает.
Опубликовал приложение в потоке, создал в Qlik Management Console задачу на загрузку данных по регламенту, но данные, которые грузятся по rest-коннектору не отображаются на листе, а данные, которые грузятся из qvd-файлов — отображаются. Хотя, если загрузить через диспетчер данных — данные есть все, что нужно.
Почему так происходит?
Неужели, прежде, чем грузить данные в память их нужно поместить в qvd-файл?
A: Пропишите все этапы загрузки данных через скрипт
Q: Есть вот такой столбик в выгружаемом файле.
Минск Слоним 18.08.17 №ТТН 4628907, 4628908 № бланка 90026854
Минск Брагин 18.08.17 №ТТН 4628905, 4628904 № бланка 90026855
Минск Столбцы 18.08.17 №ТТН 4628906 № бланка 90026873
Минск Хойники 18.08.17 №ТТН 4628875 № бланка 90026850
Мне необходимо из этого массива только номера ТТН , можно ли их как то «выдернуть» в отдельный столбец для дальнейшего использования ?
Причем в некоторых случаях ТТН идут через запятую.
A: Необходимо проверить все значения.
Если есть системность, например номера между №ТТН и №, то можно за это зацепиться и выдернуть номера используя TextBetween().
Пример по файлу ниже:
Код:
LOAD *,
trim(SubField(TextBetween(наименование,’№ТТН’,’№’ ),’,’)) as НомерТТН;
LOAD recno() as IDRow,
наименование,
ед_из,
вес,
обьем_вес,
цена_БНДС,
сумма,
НДС,
сумма_НДС,
стоимость_СНДС
FROM
[пример_qv.xlsx]
(ooxml, embedded labels, table is Лист1);
Q: Подскажите пожалуйста как добиться вот такого результата.
Причем преобразование необходимо провести на уровне скрипта.
Задача:
1. Имеем табличку, где сложены id товара и дата его наличия на складе.
2. id товара всегда уникальна
3. Если товар поступил на склад, то делается запись в таблице, если товар ушел со склада, то запись то же пропадает.
4. Нужно пронумеровать дни, 1 день, 2 день, и т.д. И если товар есть в наличии, то поставить 1, если нет записи то 0.
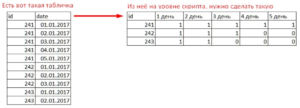
A: Необходимо отсортировать по ID товара и дате, и пронумеровать записи.
Выражение примерно такое:
…
if(id=peek(id),День+1,1) as День,
…
Можно сделать таким образом:
СкладTemp:
Load * inline
[
id,data
20,07.01.2016
14,01.01.2016
14,02.01.2016
14,03.01.2016
14,04.01.2016
14,05.01.2016
15,01.01.2016
15,02.01.2016
15,03.01.2016
15,04.01.2016
16,01.01.2016
16,02.01.2016
16,03.01.2016
20,06.01.2016
];
NoConcatenate
Склад:
LOAD
id as ID, //Field1
// data as DATA,
‘День ‘ & Day(data) & ‘ (‘ & month(data) & year(data) & ‘)’ as DAY, //Attribute
‘1’ as IN_STOCK //Value
Resident СкладTemp;
DROP TABLE СкладTemp;
temp1:
generic load * resident Склад;
result:
load distinct ID resident Склад;
drop table Склад;
FOR i = 0 to NoOfTables()
TableList:
LOAD TableName($(i)) as Tablename AUTOGENERATE 1
WHERE WildMatch(TableName($(i)), ‘temp1.*’);
NEXT i
FOR i = 1 to FieldValueCount(‘Tablename’)
LET vTable = FieldValue(‘Tablename’, $(i));
LEFT JOIN (result) LOAD * RESIDENT [$(vTable)];
DROP TABLE [$(vTable)];
NEXT i
DROP TABLE TableList;
http://i12.pixs.ru/storage/9/6/8/forumpng_6513000_24839968.png
Q:
Есть таблица с данными, отсортирована по Номенклатуре и дате. Нужно вычислить/заполнить данные в скрипте по остаткам на конец дня, на основании остатков за предыдущий день и прихода за конкретную дату. Номенклатуры есть разные, остатки на 01 число месяца также присутствуют (поле Данные).
A: load *, if(папір=peek(папір),Данные+if(isnull(прихід),0,прихід)+if(isnull(peek(zal)),0,peek(zal)),Данные) as zal Resident Ruh Order by папір, Дата ASC;
Q: Необходимо сделать выборку части данных из колонки. Выбирать надо 3 символа из строки, начиная с пятой позиции, но только для тех строк, которые начинаются на 7495.
Т.е.
Из колонки
sip:estrelcova@pit
sip:aic_om@avia
sip:aic_sklad2@aviainter
78124011111
74956171360
79218447811
74952366974
73912001356
79258582548
74997052796
надо отобрать только 617 и 236
Сейчас использую MID, но это ни то, что мне нужно.
A: Используйте условие, типа:
Если 4 левых символа = 7495, то взять три символа с пятой позиции.
Или если в запросе, то используйте where wildmatch(Строка,’7495*’) а в поле уже делайте извлечение подстроки
Q: Коллеги, помогите создать виртуальную таблицу с использованием Autogenerate.
A: А intervalmatch()?

Q: Казалось бы, воспользуйся ты функцией min(Дата счета) и прекращай заниматься ерундой в субботу вечером. Но не все так просто..
Есть еще правило: первым счетом Клиента считается такой счет, дата выставления которого больше даты выставления предыдущего счета на этого Клиента на 365 дней и более.
Пожалуй, это можно было бы реализовать на стадии скрипта загрузки, но в силу того что Счета связаны с Клиентами через несколько таблиц и наличия еще одного правила «на вырост»(в конце), я этого не делаю..
Пытаюсь выкрутить это через анализ множество, но все тщетно.
Пример не работающей формулы, которая по моей задумке должна была бы сработать:
max(
aggr({1<Номер счета = {"=rangesum(Дата счета,-below(Дата счета))>365″}>}
Дата счета,
Клиент, Дата счета(Numeric,Descending)))
)
Ситуацию еще усугубляет наличие 2х типов счетов:разовый(за одну услугу) и групповой(за несколько услуг), которые лежат в разных таблицах и конкатенировать которые пока тоже весьма затруднительно.
Но с этим я как нибудь разберусь уж..
Правило на вырост: первым счетом Клиента по Продукту считается такой счет, дата выставления которого больше даты выставления предыдущего счета на этого Клиента по этому же продукту на 365 дней.
По идее должно выглядеть как-то так:
max(
aggr({1<Номер счета = {"=rangesum(Дата счета,-below(Дата счета))>365″}>}
Дата счета,
Клиент, Продукт, Дата счета(Numeric,Descending)))
)
A: Мой совет — решить в скрипте. Слишком много вычислений в принципе, а еще и с проверкой на диапазон между датами…
Надо будет в едином реестре все счета отсортировать и расставить индексы согласно вашим установкам, причем индексы можно будет сделать разные за один запрос.
И на общий порядковый номер заказа по клиенту, и с периодами и еще с чем-то на будущее…
aggr() с множествами — отличные помощники, но не там где много записей или мало ресурсов.
Q: Занимаюсь проектом на QlikView есть проблемка.
Есть три таблицы — Таб1, Таб2, Таб3
Шаг 1. Первая грузится Таб1, Шаг 2. затем необходимо Таб2 соединить с Таб3, которая в свою очередь забирает данные для обсчета из Таб1. Шаг 3. После этого полученную таблицу на шаге 2 необходимо объединить с Таб 1.
У меня после оператора объединения сразу происходит объединение Таб1 с Таб2 и после этого соединение с Таб3. Как сделать объединение с уже объединенной таблицей Таб2 и Таб3?
A: Зачем мы грузим таб1 если нам надо надо связывать таб2 с производной от таб1?
Можно просто сделать
tmp1:
load * from tab2 ;
//tab3
left join
load * from tab1 ;
concatenate (tmp1) load … from tab1 ;

Найти решение у бизнес-партнера QlikTech (QlikView) в России.
Форум разработчиков QlikView и Qlik Sense. Получите ответы на все вопросы по QlikView и Qlik Sense!
 Опубликовано в рубрике